Разговор о Боге Гоминид: критерии, шкалы и эксперимент
- О чём это занятие
- О том, как не обмануть самого себя. Человек замечательно строит целую картину мира по немногим данным – и так же уверенно верит картине, в которой есть ошибки. Эксперимент, шкала и критерий – инструменты, которые люди придумали, чтобы пользоваться этой силой и не платить за её слабость. Сегодня те же инструменты нужны, чтобы проверять работу нейросетей: их тесты и их сравнительные таблицы.
- Аннотация
- Конспект начинается с того, в чём человеческое мышление сильнее машинного и где оно систематически ошибается: зрительные иллюзии, предвзятость подтверждения, ошибка выжившего, поиск под фонарём. Второй раздел показывает на трёх исторических опытах, как правила эксперимента – слепой метод, контрольная группа, критерий, записанный заранее, – выросли из конкретных самообманов, и как тот же самообман повторяется в машинном обучении. Третий раздел посвящён шкалам измерений: что значит измерить, чем шкала порядка отличается от шкалы отношений, какие вычисления допустимы на каждой, как сводят мнения экспертов и много критериев в одну оценку. Четвёртый объясняет, как превратить слово «удобный» в измеримый критерий и как проверить сам критерий; итог раздела – паспорт критерия. Пятый раздел излагает этапы эксперимента, прежде всего компьютерного: вычислительного, замера скорости, опыта с моделью машинного обучения. Шестой разбирает, почему сто зелёных тестов, написанных нейросетью, не доказывают, что программа работает, и какие приёмы находят ошибки, которых тесты не видят. Седьмой показывает, почему сравнительная таблица от нейросети сводится к словам «хорошо» и «плохо», и как построить таблицу с измерениями. Завершает конспект задание: найти и описать ошибки нейросети в сравнительной таблице по теме своего проекта.
- Пререквизиты
- Из занятия 3 понадобится схема аргумента «утверждение, данные, связка, оговорка»: ею записывается вывод из сравнения. Из занятия 4 – общее правило верификации: ссылку от нейросети человек открывает и сверяет сам. Здесь то же правило распространяется на числа в таблицах. Полезно вспомнить и занятие 2: что умеют современные модели и как устроены ИИ-агенты.
- Мотивация
- В отчёте по практике и в выпускной работе есть два места, где требуется доказать, а не утверждать. Первое – обзор аналогов: почему выбрана эта библиотека, чем проект отличается от существующих. Второе – глава о тестировании: что программа действительно работает. Оба места теперь заполняют с помощью нейросети за несколько минут, и результат выглядит убедительно: аккуратная таблица с галочками, сто зелёных тестов. На защите выясняется, что в таблице нет ни одного измерения, а тесты проверяют пример из задания. Чтобы этого не случилось, нужно понимать, что делает измерение измерением и проверку – проверкой, и уметь объяснить это и комиссии, и самой нейросети.
1. В чём человек силён и в чём слаб
Начнём с вопроса, который кажется давно решённым: что человек умеет лучше машины? Ответ меняется каждые несколько лет, но одна граница держится уже полвека. Компьютер выигрывает там, где можно перебрать варианты. Человек выигрывает там, где вариантов слишком мало, чтобы перебирать, – и надо по нескольким примерам понять, как устроено целое.
1.1. Перебор и понимание
В мае 1997 года шахматный компьютер Deep Blue выиграл матч из шести партий у знаменитого российского гроссмейстера со счётом 3,5 : 2,5. Машина, собранная из 480 специализированных шахматных микросхем, оценивала около 200 миллионов позиций в секунду. Человек, по оценке, которую тогда же приводила IBM, рассматривает до трёх позиций в секунду. Разница – примерно в сто миллионов раз, и всё же матч был почти равным: гроссмейстер выиграл первую партию, три закончились вничью. Шахматист не перебирает ходы: он смотрит на доску и сразу видит два-три хода, которые стоит обдумать. Остальные он отбрасывает, не рассматривая, потому что тысячи сыгранных и разобранных партий научили его узнавать расположение фигур, как слова в тексте.
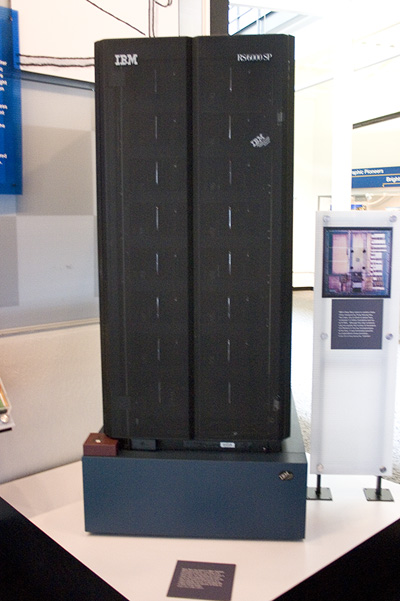
Это умение проверили опытом ещё в 1970-е годы. Гроссмейстерам и новичкам на пять секунд показывали позицию из настоящей партии, а потом просили расставить фигуры по памяти. Гроссмейстеры восстанавливали позицию почти целиком, новички – несколько фигур. Когда же фигуры расставляли на доске случайно, преимущество гроссмейстеров почти исчезало. Гроссмейстер помнит не фигуры, а смысл: знакомые группы, каждая из которых для него – одно понятие.
Отсюда наблюдение, которое называют парадоксом Моравека: то, что трудно человеку, – счёт, шахматы, доказательство теорем – машине даётся сравнительно легко, а то, что легко годовалому ребёнку, – узнать лицо, удержать равновесие, взять со стола чашку, – долго оставалось для машин почти недостижимым. Языковые модели сдвинули эту границу, но не стёрли её. В марте 2026 года вышла третья версия набора задач ARC-AGI: короткие игры-головоломки без инструкций, правила которых нужно открыть самому. Каждую из них проходят по меньшей мере двое людей, видящих её впервые; лучшие модели при выпуске набора набрали меньше одного процента.
Цифры на таких наборах быстро меняются, и это поучительно само по себе. В сентябре 2026 года одна и та же новая модель получила на ARC-AGI-3 62,7 % или 99,9 % – в зависимости от того, в какую программную обвязку её поместили. Результат «модель X решает Y» – это результат эксперимента с определёнными условиями, а не свойство модели. К этой мысли конспект ещё не раз вернётся.
1.2. Целая картина по нескольким примерам
Сила человека – строить модель мира по очень малому объёму данных. В известном опыте 1978 года трёхлетним детям один раз, мимоходом, назвали незнакомое слово: «принеси хромовый поднос, не красный, а хромовый» (так назвали оливковый цвет). Через неделю почти половина детей по просьбе «покажи хромовый» выбирала оливковый. Эффект, правда, скромнее, чем его пересказывают: оливковый выбирала и треть детей из контрольной группы, никогда не слышавших этого слова, – просто как единственный «странный» цвет. Без контрольной группы этого бы никто не заметил.
Взрослый, один раз увидевший незнакомую букву чужого алфавита, узнаёт её в другом почерке. В опыте 2015 года на наборе из 1623 рукописных символов 50 алфавитов люди по одному образцу ошибались в 4,5 % случаев, а простая свёрточная нейросеть того времени – в 13,5 %. Близких к человеку результатов добилась только модель, которая, как и человек, представляла символ последовательностью штрихов.
Зрение устроено так же. Чётко глаз видит лишь небольшую область в центре поля зрения, а в каждом глазу есть слепое пятно – место, где зрительный нерв выходит из сетчатки и светочувствительных клеток нет вовсе. Мы этого не замечаем: мозг собирает картину из коротких взглядов и достраивает недостающее по тому, что ожидает увидеть. Мир кажется полным, потому что мозг постоянно предсказывает его.
На этой способности держатся и наука, и инженерия: по нескольким наблюдениям вывести правило и применить его там, где наблюдений ещё не было.
1.3. Обратная сторона: мозг достраивает то, чего нет
Механизм, который по малым данным строит полную картину, ошибается так же уверенно, как и угадывает. На рисунке ниже два отрезка. Какой длиннее?
Отрезки равны, и это легко проверить линейкой. Важнее другое: после проверки нижний отрезок всё равно кажется длиннее. Знание не исправляет восприятие. Исправляет его только прибор – линейка, которая не знает, что ей «должно» показаться.
Ещё нагляднее иллюзия с шахматной доской. Клетки A и B на левом рисунке закрашены одним и тем же серым. Поверить в это невозможно, пока их не соединят полосой того же цвета, как на правом рисунке, а стоит полосу убрать – и иллюзия возвращается. Мозг не измеряет яркость клетки, а вычисляет, какой она «должна быть» с поправкой на тень.
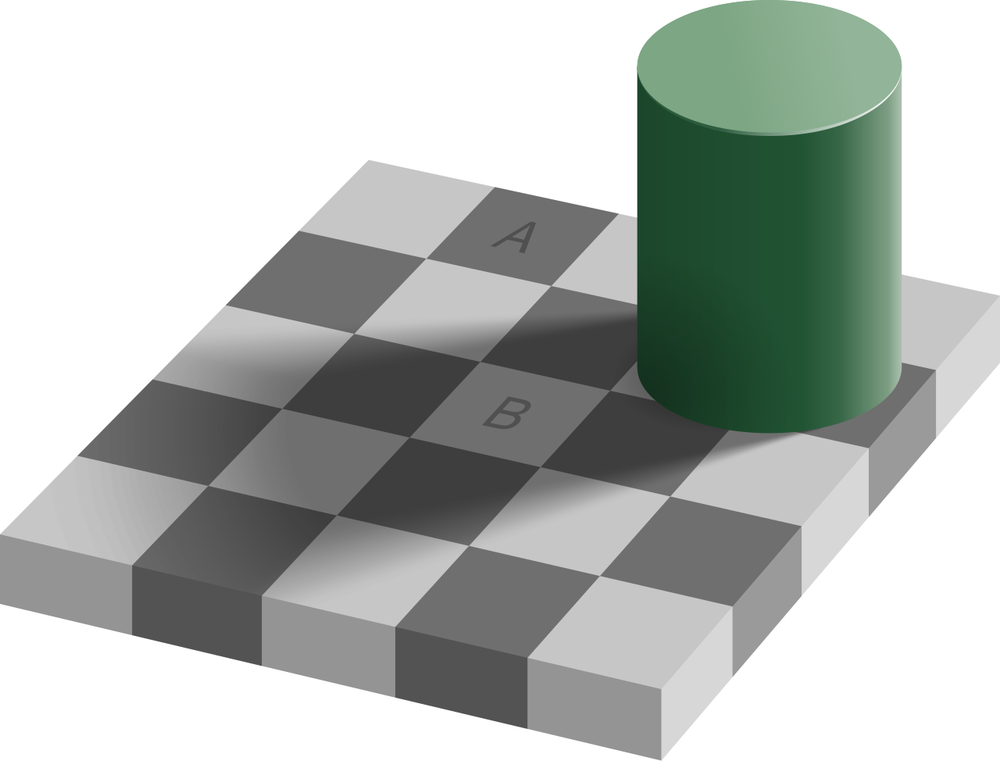
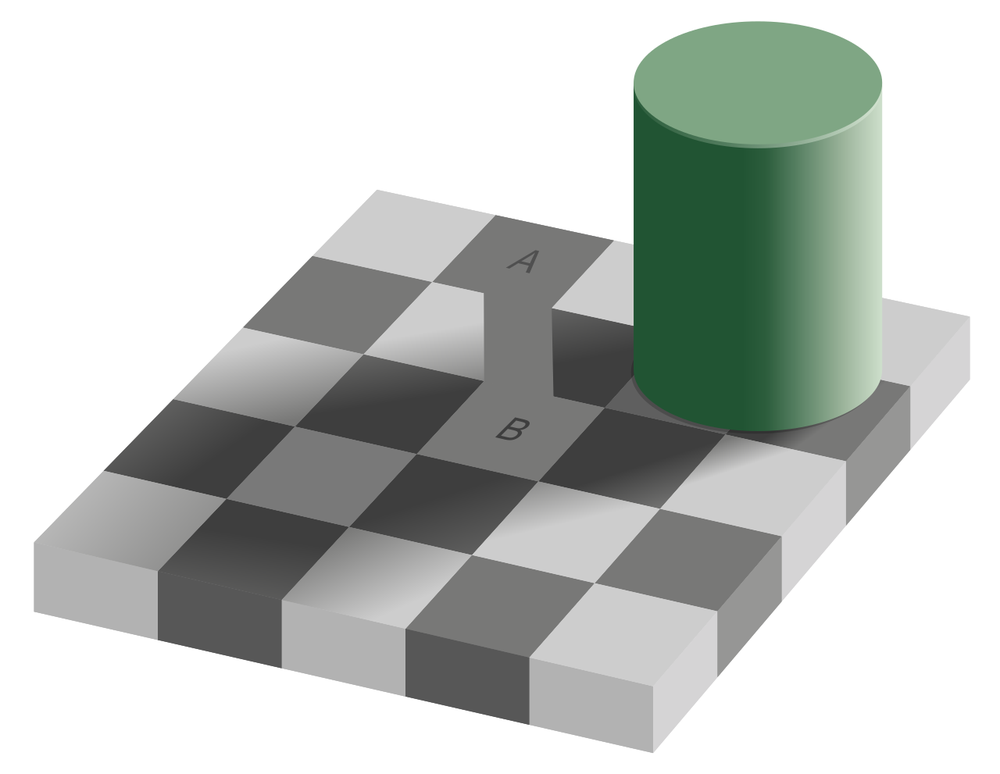
Восприятие ошибается и иначе: оно не видит того, чего не ждёт. В известном опыте 1999 года зрителей просили сосчитать, сколько раз игроки в белых футболках передали друг другу мяч. Посреди ролика через площадку на пять секунд проходила женщина с зонтом или человек в костюме гориллы. Неожиданное событие не заметили 46 % из 192 зрителей, а гориллу – больше половины. Это явление называют слепотой невнимания. Программист встречается с ним каждый день: перечитывая свой код, он видит то, что собирался написать, а не то, что написал. Поэтому опечатку в собственном коде быстрее находит товарищ, а ошибку в собственном рассуждении – оппонент.
1.4. Ошибки суждения
Ошибки бывают не только в восприятии, но и в рассуждении. Самая важная для нас – предвзятость подтверждения: человек ищет и замечает доводы в пользу того, во что уже верит, и не ищет опровержений. Её классический опыт поставлен в 1960 году, и устроен он так.
- Участники. 29 студентов, по одному.
- Задание. Экспериментатор говорит: «Тройка чисел 2, 4, 6 подчиняется простому правилу, которое я загадал. Найдите это правило».
- Как можно действовать. Участник называет свои тройки, сколько угодно, и для каждой записывает, почему он её выбрал. Экспериментатор на каждую отвечает только одно: «подходит» или «не подходит».
- Окончание. Когда участник уверен, он называет правило. Если правило неверно, ему говорят об этом, и он продолжает проверять тройки.
- Что измеряли. Назвал ли участник правило верно с первой попытки, и какие тройки он для этого проверял.
Загаданное правило очень широкое: любые три числа по возрастанию. А в голову первыми приходят узкие догадки: «чётные числа через два», «каждое следующее больше на одно и то же число». Узкая догадка лежит целиком внутри широкого правила, и в этом весь замысел опыта.
Попробуйте сами, прежде чем читать результат.
Тройка чисел 2, 4, 6 подчиняется правилу, которое загадано заранее. Введите свою тройку и нажмите «Проверить»: справа появится ответ, подходит ли она под правило. Проверяйте столько троек, сколько нужно, а когда будете уверены, нажмите «Я знаю правило» и выберите его из списка.
В исходном опыте правило с первой попытки назвали верно только 6 человек из 29. Тринадцать назвали одно неверное правило, девять – два и больше, один так и не пришёл к ответу. Типичный участник придумывал догадку вроде «чётные числа через два», проверял тройки 8, 10, 12 и 20, 22, 24, получал «подходит» и объявлял догадку доказанной. Почти никто не пробовал тройку, которая по его догадке подходить не должна, например 1, 2, 3. А именно она и показала бы, что правило шире. Проверки, которые не могут закончиться ответом «нет», не несут информации. Запомним это: в разделе 6 так же будут устроены тесты, которые пишет нейросеть.
У предвзятости подтверждения много родственников. Два из них стоит знать по именам, потому что они то и дело встречаются в отчётах.
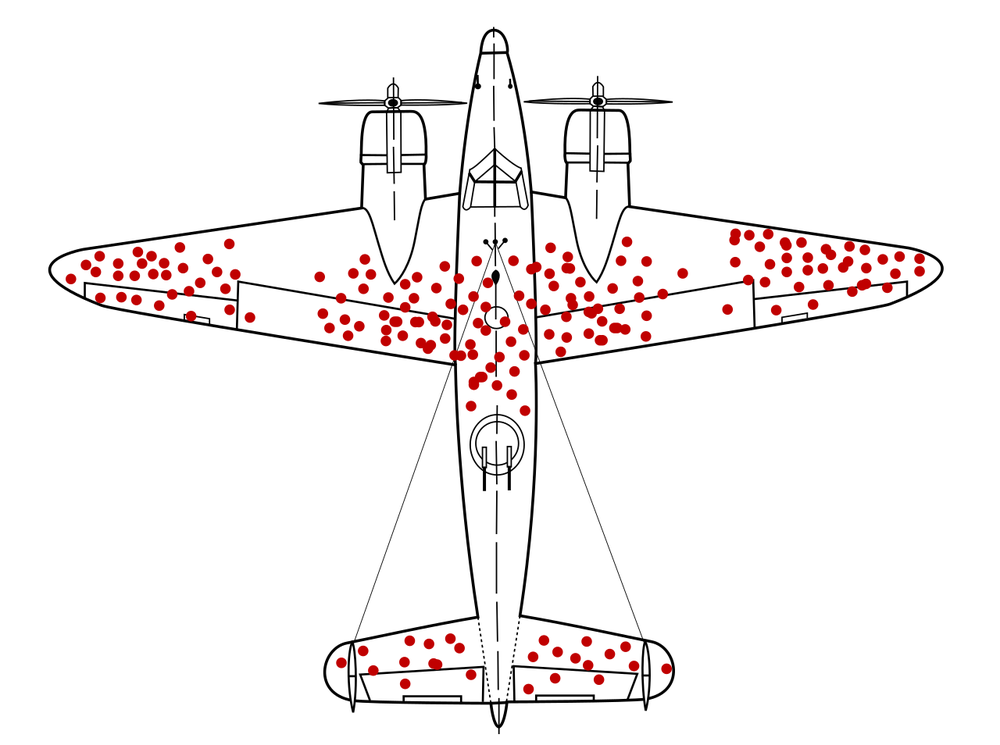
- Ошибка выжившего. В 1943 году статистик Абрахам Вальд разработал способ оценить, попадания в какие части самолёта смертельны, по повреждениям только тех машин, что вернулись. Главная мысль: пробоины видны лишь у выживших. Если у вернувшихся самолётов почти нет попаданий в какое-то место, значит, самолёты, получившие их туда, не вернулись, – и броня нужна именно там. Знаменитая картинка самолёта с красными точками – позднейшая иллюстрация 2016 года, в документах Вальда её нет. В программировании так же обманывают отзывы пользователей: их пишут те, кто не удалил приложение после первой ошибки.
- Регрессия к среднему. Если результат был крайне плохим, следующий почти наверняка будет лучше – и без всякого вмешательства, просто потому что крайние значения редки. Инструкторы лётной подготовки заметили, что после похвалы за особенно мягкую посадку следующая обычно хуже, а после разноса за грубую – лучше, и решили, что наказание полезнее поощрения. Похвала и разнос тут ни при чём. Тот же механизм «доказывает» пользу любого исправления, сделанного после самого медленного запуска программы.
1.5. Поиск под фонарём
Есть притча, которую рассказывают о Ходже Насреддине. Ночью Насреддин что-то ищет под уличным фонарём. Прохожий спрашивает, что он потерял. «Ключ». – «Где?» – «Дома». – «Почему же ты ищешь здесь?» – «Здесь светлее». Самые ранние известные записи этой истории, впрочем, не восточные: это американские газеты 1920-х годов, где под фонарём ищет потерянную купюру безымянный прохожий.
Притча смешна, пока не узнаёшь в ней себя. Учёные и инженеры постоянно ищут там, где легко искать: измеряют то, что легко измерить, проверяют то, что легко проверить, читают то, что легко найти. В науке это называют эффектом уличного фонаря. Его опасность в том, что поиск под фонарём выглядит как настоящая работа: свет есть, человек занят, отчёт о проделанном можно написать. Только ключа там нет.
Человеческое мышление, таким образом, сильно и слабо одним и тем же свойством: оно строит целую картину по немногим данным и потом в эту картину верит. Чтобы пользоваться силой и не платить за слабость, люди придумали особую процедуру – эксперимент.
2. Эксперимент: как не обмануть самого себя
Отрезки Мюллера-Лайера выравнивает линейка. Для суждений нужна такая же линейка – процедура, которая не знает, какого ответа мы ждём. Эксперимент и есть такая процедура: опыт, поставленный так, чтобы ни надежды экспериментатора, ни его восприятие не могли повлиять на результат. Каждый его элемент появился как ответ на конкретный самообман. Три истории показывают, какие.
2.1. Лошадь, которая умела считать
В начале XX века в Берлине прославился конь по кличке Умный Ганс. Его хозяин, учитель математики, задавал ему арифметические задачи, и Ганс выстукивал ответ копытом. Он складывал, умножал, читал числа на карточках и, казалось, понимал по-немецки. В 1904 году комиссия из тринадцати человек – психолог, ветеринар, директор зоопарка, кавалерийский офицер, учителя, цирковой дрессировщик – обмана не нашла: хозяин искренне верил в способности коня.
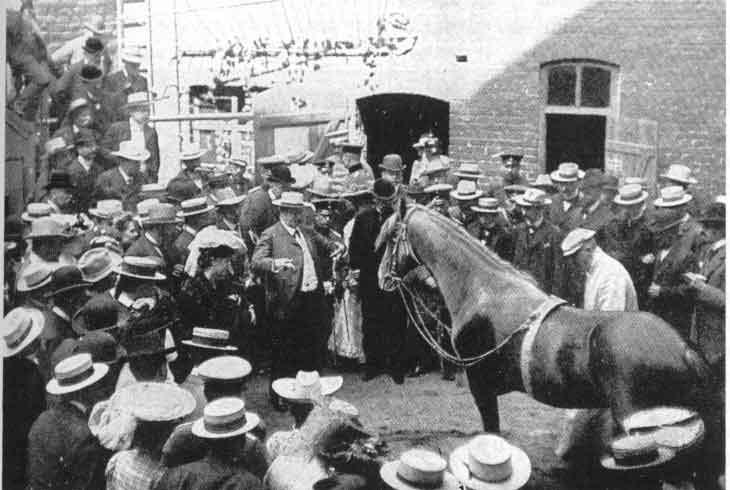
Разгадку нашёл молодой психолог, который поставил опыты, а не наблюдал представления. Он менял условия по одному. Когда спрашивающий сам знал ответ, Ганс читал числа на карточках верно в 98 % случаев; когда не знал – в 8 %. Когда конь видел спрашивающего, верных ответов было 89 %; когда на коня надевали шоры – 6 %. Ганс не считал. Он стучал, пока не замечал едва уловимое движение человека: спрашивающий невольно чуть наклонялся, пока конь бил копытом, и выпрямлялся, когда число ударов доходило до верного. Никто, включая хозяина, этих движений за собой не знал. Психолог научился сам угадывать задуманные людьми числа по тем же движениям.
Из этой истории вырос слепой метод: тот, кто проводит опыт или оценивает результат, не должен знать, какой ответ «правильный» или какой вариант перед ним. Сама идея старше Ганса: ещё в 1784 году комиссия, в которую входили Бенджамин Франклин и Антуан Лавуазье, проверяла модный тогда «животный магнетизм» и завязывала испытуемым глаза. Человек падал в обморок у дерева, которое считал «намагниченным», хотя «намагнитили» другое, и выдавал все «магнетические» реакции после обычной воды, которую ему выдали за намагниченную. Комиссия заключила, что действует воображение.
2.2. Лучи, которые видел только автор
В 1903 году уважаемый французский физик объявил об открытии нового излучения – N-лучей. По его наблюдениям, лучи усиливали яркость слабой искры и разлагались призмой в спектр. За год, по подсчётам историков, около 120 учёных опубликовали примерно 300 статей с «наблюдениями» этих лучей. Но многие лаборатории воспроизвести их не смогли.
В 1904 году в лабораторию приехал американский физик. Во время измерения спектра, в темноте, он незаметно вынул из прибора призму, которая должна была разлагать лучи. Экспериментатор продолжал видеть те же линии спектра. Лучей не было: были ожидания наблюдателя, который знал, что должен увидеть. Заметка об этом опыте вышла в журнале Nature в сентябре 1904 года, и вскоре за пределами лаборатории, где лучи «открыли», в них уже почти никто не верил.
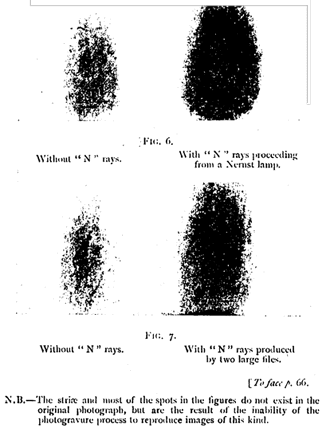
Вывод тот же, что в истории с Гансом, но обращён к самому учёному.
2.3. Опыт с контрольной группой
Третья история старше. В мае 1747 года корабельный врач британского флота взял двенадцать моряков, больных цингой, с возможно более сходными признаками болезни, разделил их на шесть пар и при одинаковом рационе дал каждой паре своё средство: сидр, разбавленную серную кислоту, уксус, морскую воду, лечебную пасту – и два апельсина и лимон в день. Фруктов хватило на шесть дней. К концу этого срока один из моряков, получавших цитрусовые, вернулся к службе, второй почти поправился; у остальных заметное улучшение было лишь у пары, пившей сидр. Сравнение одновременно и в одинаковых условиях показало то, чего не показали бы годы наблюдений за отдельными больными.
Главная мысль опыта в том, что результат лечения сравнивают не с ожиданиями, а с другими больными, которых лечили иначе. Без такой контрольной группы любое улучшение можно приписать средству, хотя больной, возможно, выздоровел бы и сам: это та самая регрессия к среднему из раздела 1.4.
У истории есть поучительное продолжение. Сам автор опыта не сделал из него вывода, что цитрусовые – лучшее средство: он верил, что у цинги много причин, и советовал уваренный сок, в котором нужное вещество разрушается при кипячении. Регулярную выдачу лимонного сока британский флот ввёл только почти через полвека, в 1795 году. Данные – ещё не вывод: если вывод подгоняют под любимую теорию, даже хороший опыт пропадает зря.
2.4. Из чего состоит хороший опыт
Из таких историй и сложились правила, по которым ставят эксперимент. Каждое правило закрывает одну дыру восприятия или суждения.
- Гипотеза, которую можно опровергнуть. «Новая версия работает хорошо» опровергнуть нельзя, а «новая версия обрабатывает запрос быстрее на 20 % при той же нагрузке» – можно. Утверждение, которое согласуется с любым исходом, не проверяется никаким опытом.
- Критерий успеха – до опыта. Что измеряем, в какой шкале и какой результат считаем успехом, записывают заранее. Иначе после опыта всегда найдётся показатель, по которому «получилось». В науке для этого придумали предварительную регистрацию: план исследования публикуют до того, как собраны данные.
- Сравнение. Результат сравнивают с контрольной группой, с базовой версией, с известным решением. Число без сравнения – не результат.
- Случайное распределение. Кто попадёт в какую группу, решает жребий, а не экспериментатор: иначе он, сам того не желая, отправит «лучших» в свою группу.
- Слепота. Тот, кто измеряет или оценивает, не знает, какой вариант перед ним.
- Повторение. Одно наблюдение может быть случайностью. Опыт повторяют и сообщают не только среднее, но и разброс; а лучше всего – когда опыт повторяет другая команда.
Последнее правило оказалось самым трудным. В 2015 году большая группа исследователей повторила сто опубликованных психологических опытов. В оригинальных статьях значимый результат был в 97 % случаев, при повторении – в 36 %, а средний размер эффекта оказался вдвое меньше. Это назвали кризисом воспроизводимости, и он касается не только психологии.
Свежий пример того, зачем всё это программисту. В 2025 году шестнадцать опытных разработчиков открытого кода выполнили 246 настоящих задач в своих проектах; для каждой задачи жребий решал, можно ли пользоваться ИИ-помощником. Перед опытом разработчики ожидали, что ИИ ускорит их работу на 24 %, после опыта считали, что ускорил на 20 %. Измерение показало, что с ИИ они работали на 19 % медленнее. Повторное исследование 2026 года на большей выборке дало уже другую картину, но сами его авторы называют свидетельства слабыми. Ощущение «с ИИ я быстрее» – это гипотеза, а не результат: её проверяют только жребием и секундомером.
Физик Ричард Фейнман сформулировал всё это одной фразой в речи перед выпускниками Калтеха в 1974 году. По-русски речь известна как «Наука самолётопоклонников»:
2.5. Умный Ганс в машинном обучении
У истории с Гансом есть продолжение, которое прямо касается программистов. Модель машинного обучения, как и лошадь, может давать верные ответы по неверной причине. Исследователи так и называют это явление – «эффект Умного Ганса».
- Лошади. В 2019 году проверили, на какие пиксели смотрит классификатор изображений, хорошо узнававший лошадей в известном наборе фотографий. Оказалось, что на подпись фотографа в углу кадра: такая подпись была примерно на каждой пятой фотографии лошади. Стоило вклеить подпись в снимок спортивного автомобиля, и классификатор называл его лошадью. Артефакт набора данных почти десять лет оставался незамеченным.
- Рентген. Модель, искавшая пневмонию на рентгеновских снимках из трёх больниц, научилась с точностью выше 99 % узнавать, из какой больницы снимок, а пневмония в этих больницах встречалась с очень разной частотой. На снимках из незнакомой больницы качество модели заметно падало.
- Маркер. Сертифицированная нейросеть для распознавания меланомы стала принимать за меланому безобидные родинки, обведённые фиолетовым хирургическим маркером: доля верно распознанных доброкачественных образований упала с 84 до 46 %. Когда пометки обрезали, качество вернулось.
Такое обучение по короткому пути не видно на проверочной выборке, если она собрана так же, как обучающая: подпись есть и там. Его выявляет только опыт с изменёнными условиями – тот же приём, что раскрыл Ганса. Уберите подпись и посмотрите, упадёт ли точность. Проверьте модель на снимках из другой больницы. Известный пример с классификатором «волк или хаски», который смотрел на снег вокруг животного, тоже был таким опытом: исследователи нарочно обучили испорченную модель, чтобы проверить, заметят ли подвох люди, которым показывают объяснения её решений.
Во всех этих историях результат решало измерение: число ударов копытом, яркость искры, число выздоровевших, доля верных ответов. Но измерение тоже можно сделать так, что оно ничего не скажет. Как измерять правильно, разбирает следующий раздел.
3. Шкалы измерений
Любой опыт из предыдущего раздела заканчивается одинаково: что-то измерили и сравнили. Лошадь выстукивала число, моряков после лечения осматривали, прибор показывал яркость искры. Сравнивать можно только то, что записано так, что сравнение имеет смысл. Правила такой записи и называются шкалами. Без них даже честно поставленный опыт превращается в набор впечатлений.
3.1. Что значит измерить
Измеряют не сами объекты, а их свойства. Нельзя измерить программу, но можно измерить время её работы, объём занятой памяти, число найденных в ней ошибок. Нельзя измерить команду, но можно измерить её численность или долю задач, закрытых в срок.
Кроме свойства, у измерения есть второй элемент – отношение между объектами. Программы можно сравнивать по отношению «работает быстрее», ошибки – по отношению «серьёзнее», библиотеки – по отношению «эта та же самая». Измерить – значит сопоставить каждому объекту знак (число или имя) так, чтобы отношение между знаками повторяло отношение между объектами.
Формально шкала записывается тройкой
\[ \langle X,\ \varphi,\ Y \rangle, \qquad X = \{x_1, \dots, x_n;\ R_x\}, \qquad Y = \{\varphi(x_1), \dots, \varphi(x_n);\ R_y\}. \]
Здесь \(X\) – эмпирическая система: объекты и отношение \(R_x\) между ними, которое нас интересует. \(Y\) – знаковая система: значения, которые получили объекты, и отношение \(R_y\) между значениями. \(\varphi\) – правило сопоставления, причём такое, что значения связаны отношением \(R_y\) тогда и только тогда, когда сами объекты связаны отношением \(R_x\):
\[ \bigl(\varphi(x_1), \dots, \varphi(x_n)\bigr) \in R_y \iff (x_1, \dots, x_n) \in R_x. \]
В математике такое отображение, сохраняющее отношения, называется гомоморфизмом.
Определение отсекает много чисел, которые только выглядят как результаты измерения. Номер аудитории 405 больше номера 203, но аудитория от этого не становится просторнее. Порт 8080 не «вдвое больше» порта 4040. Это имена, записанные цифрами: отношение «больше» между ними ничему не соответствует. С такими числами можно делать только одно – проверять, совпадают ли они.
3.2. Пять типов шкал
Шкалы различаются тем, какие отношения между объектами они сохраняют. Чем больше отношений сохранено, тем «сильнее» шкала и тем больше действий с её значениями разрешено. Принято выделять пять типов. Эта классификация закреплена и в российской метрологии: типы шкал измерений определяет рекомендация РМГ 83-2007 «Шкалы измерений. Термины и определения». На схемах ниже, как в формуле выше, верхний ряд – эмпирическая система (объекты), нижний – знаковая (их значения).
Шкала наименований
Шкала наименований (номинальная) – самая слабая. Каждому объекту сопоставляется имя класса, и измерение состоит в том, чтобы отнести объект к классу эквивалентности. Язык программирования, операционная система, лицензия, тип ошибки – номинальные признаки.
С результатом можно сделать немногое: проверить, в одном ли классе два объекта, и посчитать, сколько объектов попало в каждый класс, – здесь 2, 4 и 2 из 8. Если обозначить совпадение классов как \(\delta_{ij} = 1\), когда \(\varphi(x_i) = \varphi(x_j)\), и \(\delta_{ij} = 0\) иначе, то частота класса \(k\) равна \(p_k = \frac{1}{n} \sum_j \delta_{kj}\). Имена классов можно заменить любыми другими, лишь бы разным классам достались разные имена: смысл не изменится.
Шкала порядка
Шкала порядка (ранговая) сохраняет ещё и отношение «больше – меньше»: если \(x_1 \succ x_2\), то \(\varphi(x_1) > \varphi(x_2)\). По ней располагают объекты по возрастанию или убыванию качества: места в соревновании, курсы обучения, приоритет задачи («блокирующая», «критическая», «значительная», «незначительная»), оценки «отлично – хорошо – удовлетворительно».
Расстояний между ступенями шкала порядка не знает. Спортсмен, занявший четвёртое место, бежал не в четыре раза медленнее победителя, и разрыв между первым и вторым местом может быть секундой, а между вторым и третьим – минутой. Если несколько объектов нельзя упорядочить, потому что они равноценны, говорят о шкале квазипорядка: равным объектам дают одинаковый ранг.
Классический пример шкалы порядка – сила землетрясения в баллах: по российскому стандарту ГОСТ Р 57546-2017 их двенадцать, и каждый описан тем, что чувствуют люди и что происходит с предметами и зданиями. Нельзя сказать, что толчок в 2 балла в пять раз слабее десятибалльного. Часто здесь же называют «шкалу Рихтера», но это неточно: магнитуда по Рихтеру – не балл, а логарифм отношения амплитуд колебаний, и разность магнитуд осмысленна (на единицу больше – амплитуда в десять раз больше). Фраза «7 баллов по шкале Рихтера» смешивает две разные шкалы.
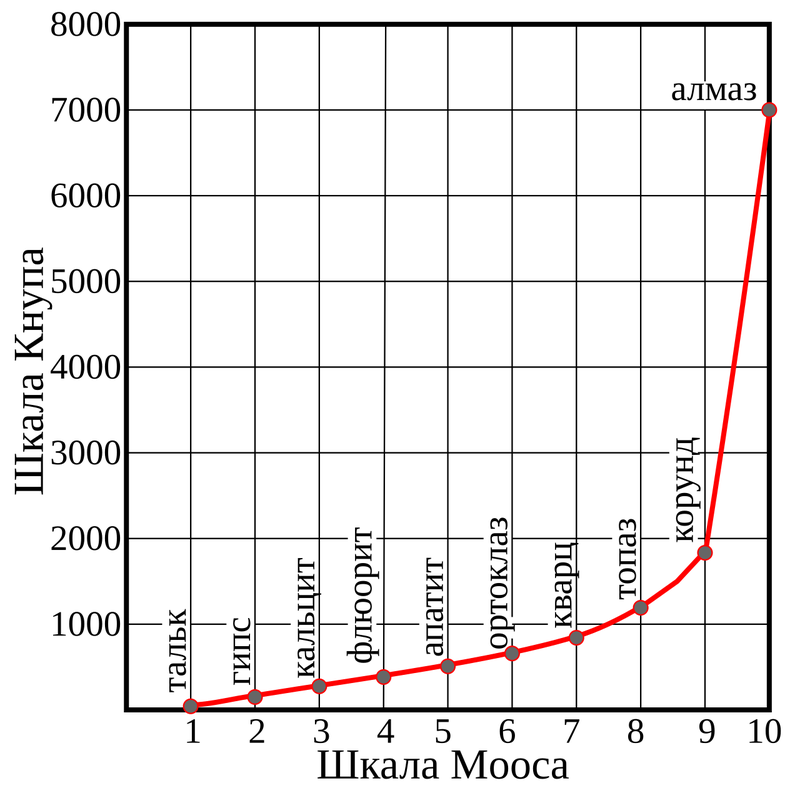
Так же устроена шкала твёрдости минералов Мооса: минерал с большим номером царапает минерал с меньшим, и больше шкала ничего не утверждает. Если измерить твёрдость прибором, видно, насколько неравны её ступени.
Шкала интервалов
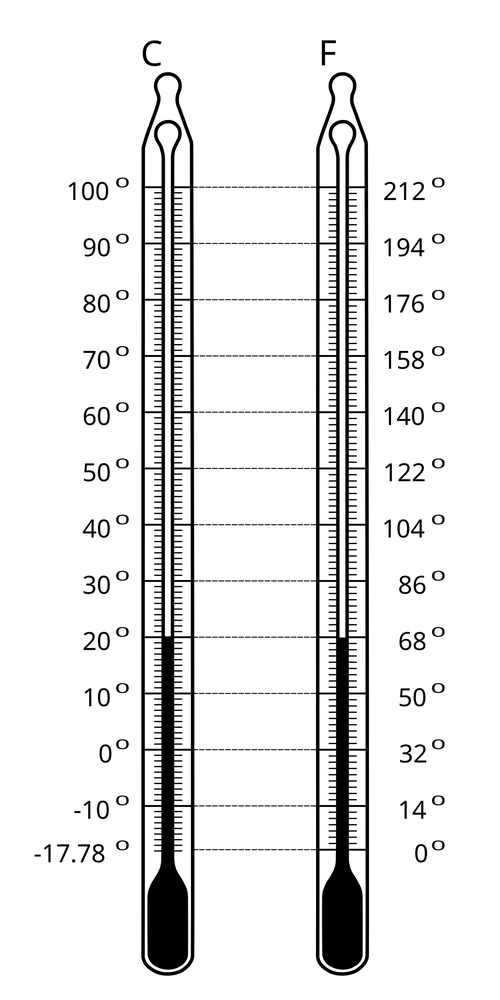
Шкала интервалов известна тогда, когда упорядочение настолько точное, что известны расстояния между объектами, выраженные в одинаковых по всей шкале единицах. Начало отсчёта при этом выбирается по соглашению. Так устроены температура в градусах Цельсия и Фаренгейта, календарные даты, время суток, высота над уровнем моря. Для программиста самый знакомый пример – время Unix: секунды от полуночи 1 января 1970 года. Ноль здесь – договорённость, а не отсутствие времени.
Одно и то же свойство можно измерить в разных интервальных шкалах; они связаны преобразованием \(\varphi'(x) = a\,\varphi(x) + b\), \(a > 0\). При таком преобразовании сохраняются отношения интервалов:
\[ \frac{\varphi(x_1) - \varphi(x_2)}{\varphi(x_3) - \varphi(x_4)} = \frac{\varphi'(x_1) - \varphi'(x_2)}{\varphi'(x_3) - \varphi'(x_4)}. \]
Только интервалы имеют смысл настоящих чисел, и только над интервалами можно выполнять арифметические действия.
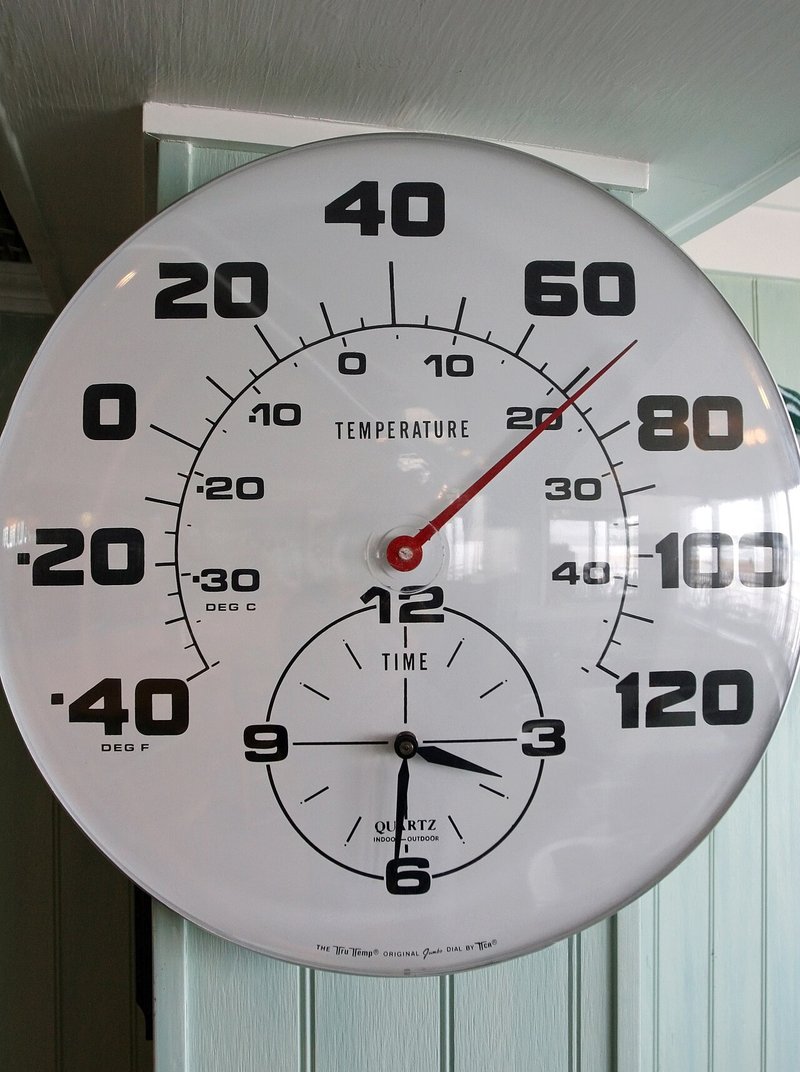
На бытовом термометре с двумя шкалами это видно без формул: одна стрелка показывает два разных числа, и ни одно из них не «правильнее» другого. Нули у шкал разные, и оба выбраны по соглашению.
Шкала отношений
Шкала отношений имеет естественный ноль: ноль килограммов значит «массы нет», ноль миллисекунд – «время не прошло». Свободен только выбор единицы: массу можно измерять в килограммах или фунтах, длину – в метрах или аршинах. Шкалы связаны преобразованием \(\varphi'(x) = a\,\varphi(x)\), и при смене единицы сохраняется отношение значений: \(\varphi(x_1) / \varphi(x_2) = \varphi'(x_1) / \varphi'(x_2)\).
Время отклика, объём памяти, размер пакета, цена – признаки шкалы отношений. С их значениями можно выполнять любые арифметические действия.
Абсолютная шкала
Абсолютная шкала имеет не только естественный ноль, но и естественную единицу. Это счёт: число ошибок, тестов, пользователей, а также безразмерные доли и вероятности. Других шкал, эквивалентных абсолютной, нет: число найденных ошибок нельзя «перевести в другие единицы». Над её значениями можно выполнять всё, вплоть до возведения в степень и логарифмирования.
Тип шкалы определяется тем, какие свойства есть у отношения между объектами. Если выполняются только аксиомы тождества (\(A = A\); если \(A = B\), то \(B = A\); если \(A = B\) и \(B = C\), то \(A = C\)), шкала – наименований. Если к ним добавляются аксиомы порядка (из \(A \ne B\) следует \(A > B\) или \(B > A\); из \(A > B\) и \(B > C\) следует \(A > C\)), – порядка. Если известны расстояния – интервалов. Если, кроме того, выполняются аксиомы сложения (\(A + B = B + A\), \((A + B) + C = A + (B + C)\) и т. д.), – отношений.
3.3. Что можно делать с числами каждой шкалы
Шкала определяет не только запись, но и то, какие вычисления с результатами осмысленны. Правило простое: осмысленно только то, что не меняется при допустимом для шкалы преобразовании.
| Шкала | Допустимое преобразование | Осмысленные операции | Бессмысленные операции |
|---|---|---|---|
| наименований | любая замена имён один к одному | совпадает / не совпадает, частоты, мода | упорядочить, сложить, усреднить |
| порядка | любое строго возрастающее | плюс медиана, процентили, ранговые коэффициенты | разность рангов, среднее рангов |
| интервалов | \(y = ax + b,\ a > 0\) | плюс разности, среднее, стандартное отклонение | «во столько-то раз больше» |
| отношений | \(y = ax,\ a > 0\) | плюс отношения «во сколько раз», среднее геометрическое | – |
| абсолютная | только тождественное | всё, включая показатель степени и логарифм | – |
Это правило удобнее всего увидеть на одном наборе данных. Пять бегунов пробежали 100 метров: Аня – за 12,1 с, Борис – за 12,4, Вика – за 13,0, Глеб – за 15,8, Дина – за 16,0. Тот же забег можно записать четырьмя способами.
- Наименований. Судья на финише отметил, кто финишировал вплотную друг к другу, и пометил группы цветом: Аня и Борис – синие, Вика – зелёная, Глеб и Дина – жёлтые. В таблицу данных цвета, как это часто бывает, записали кодами 1, 2 и 3.
- Порядка. Место в забеге.
- Интервалов. Время финиша по часам стадиона; когда прозвучал выстрел стартёра, в записи нет.
- Отношений. Время на дистанции по секундомеру, запущенному выстрелом.
| Бегун | Наименований: группа на финише | Порядка: место | Интервалов: время финиша по часам | Отношений: время на дистанции, с |
|---|---|---|---|---|
| Аня | синяя (1) | 1 | 10:00:12,1 | 12,1 |
| Борис | синяя (1) | 2 | 10:00:12,4 | 12,4 |
| Вика | зелёная (2) | 3 | 10:00:13,0 | 13,0 |
| Глеб | жёлтая (3) | 4 | 10:00:15,8 | 15,8 |
| Дина | жёлтая (3) | 5 | 10:00:16,0 | 16,0 |
Каждая запись честная, но каждая знает о забеге разное. По первой нельзя сказать, кто быстрее, по второй – насколько быстрее, по третьей – во сколько раз: ноль на часах стадиона ничего не значит для бега. Проверьте это сами: тренажёр применяет к каждой записи допустимое для неё преобразование и показывает, какие ответы его переживают.
Пять бегунов пробежали 100 м. Один и тот же забег записан четырьмя способами – в четырёх шкалах. Выберите шкалу кнопкой сверху. Для каждого из четырёх вопросов решите, можно ли отвечать на него по этой записи, и нажмите «Проверить». Тренажёр применит к записи допустимое для шкалы преобразование и покажет, сохранился ли ответ: если ответ меняется, вопрос для этой шкалы бессмыслен.
Со шкалой порядка ошибаются чаще всего, потому что её значения выглядят как числа. Оценки от 1 до 5 в опросе «насколько удобен интерфейс» – порядковые: нет оснований считать, что расстояние между «2» и «3» такое же, как между «4» и «5». Что из этого следует, видно на примере. Две версии интерфейса оценили по пять человек.
| Оценки | Среднее | Среднее после замены \(x \to x^2\) | Медиана | |
|---|---|---|---|---|
| Версия A | 1, 1, 5, 5, 5 | 3,4 | 15,4 | 5 |
| Версия B | 3, 3, 4, 4, 4 | 3,6 | 13,2 | 4 |
По средним лучше версия B. Но для порядковой шкалы замена кодов 1…5 на их квадраты допустима: порядок ступеней сохранился, а ничего другого шкала и не знала. После такой замены по средним лучше уже A. Вывод перевернулся от того, какие числа мы случайно приписали словам. Медиана в обоих случаях говорит одно и то же: A лучше. Поэтому для порядковых шкал сообщают медиану и распределение ответов; так прямо сказано и в РМГ 83-2007.
На практике средние по таким шкалам считают постоянно, и среди методистов об этом идёт давний спор. Компромисс такой: среднее допустимо, если ответ складывается из многих однотипных вопросов, и стоит проверить, не меняется ли вывод, если взять медиану. Для одного вопроса с пятью вариантами честнее показать, сколько человек выбрало каждый вариант.
3.4. Когда прибора нет: экспертные оценки
Измерения бывают объективными и субъективными. Объективные выполняет прибор: часы, весы, профилировщик. Субъективные выполняет человек: так оценивают качество продукта, удобство интерфейса, важность требования, соответствие задаче. Результат субъективного измерения – словесная оценка («плохо», «хорошо») или число, которое выражает степень качества либо место объекта среди других. Когда команда «выбирает лучшую библиотеку» или «оценивает удобство», она проводит именно субъективное измерение, и его надо проводить по правилам. Таких правил четыре основных.
Ранжирование. Каждый эксперт упорядочивает объекты, присваивая им ранги: 1 – лучший. Равноценным объектам дают одинаковый ранг, равный среднему тех мест, которые они делят: если два продукта делят второе и третье места, каждый получает ранг 2,5. Мнения нескольких экспертов сводят методом суммы мест: ранги складывают, и лучшим считается объект с наименьшей суммой.
| Эксперт | П1 | П2 | П3 |
|---|---|---|---|
| Эксперт 1 | 3 | 2 | 1 |
| Эксперт 2 | 2 | 3 | 1 |
| Эксперт 3 | 3 | 1,5 | 1,5 |
| Сумма рангов | 8 | 6,5 | 3,5 |
| Итоговый ранг | 3 | 2 | 1 |
Итоговый ранг ничего не говорит о том, насколько эксперты были согласны между собой. Для этого служит коэффициент конкордации (согласованности) Кендалла:
\[ W = \frac{12\,S}{m^2 (n^3 - n) - m \sum_s T_s}, \qquad S = \sum_{i=1}^{n} \Bigl(\sum_{j=1}^{m} r_{ij} - \bar r\Bigr)^2, \qquad T_s = \sum_k \bigl(t_k^3 - t_k\bigr), \]
где \(m\) – число экспертов, \(n\) – число объектов, \(r_{ij}\) – ранг объекта \(i\) у эксперта \(j\), \(\bar r\) – средняя сумма рангов, \(t_k\) – число объектов в \(k\)-й группе с одинаковым рангом у эксперта \(s\). \(W = 1\) при полном согласии и \(W = 0\), когда согласия нет вовсе. В примере средняя сумма рангов равна 6, \(S = 2^2 + 0{,}5^2 + (-2{,}5)^2 = 10{,}5\), у третьего эксперта одна пара равных рангов (\(T = 2^3 - 2 = 6\)), и
\[ W = \frac{12 \cdot 10{,}5}{9 \cdot 24 - 3 \cdot 6} = \frac{126}{198} \approx 0{,}64. \]
Согласие заметное, но при трёх экспертах и трёх объектах оно ещё не доказано: проверка значимости (\(\chi^2 = m (n - 1) W \approx 3{,}8\) при критическом значении 6,0 для двух степеней свободы) говорит, что такое согласие могло получиться случайно. Мало экспертов – мало уверенности. Общепринятых порогов «хорошего» \(W\) нет; важнее сравнивать согласие до и после обсуждения и смотреть, по каким объектам эксперты расходятся.
Парные сравнения. Эксперт сравнивает каждую пару объектов и записывает результат в матрицу: \(w_{ij} = 1\), если объект \(i\) не хуже объекта \(j\), иначе 0.
| П1 | П2 | П3 | |
|---|---|---|---|
| П1 | 1 | 1 | 1 |
| П2 | 0 | 1 | 0 |
| П3 | 0 | 1 | 1 |
Матрица должна быть согласованной: на диагонали единицы; если \(w_{ij} = 1\), то \(w_{ji} = 0\); если \(w_{ij} = 1\) и \(w_{jk} = 1\), то \(w_{ik} = 1\). Нарушение последнего условия – сигнал, что эксперт сравнивал по разным признакам или устал. Сумма по столбцу показывает, сколько объектов не хуже данного, и даёт его место: в примере П1 – первое (сумма 1), П3 – второе (2), П2 – третье (3). Матрицы нескольких экспертов сводят по большинству: элемент итоговой матрицы равен 1, если так решила хотя бы половина экспертов.
Непосредственная оценка. Эксперт ставит каждому объекту число – балл по пятибалльной, десятибалльной или стобалльной шкале или долю от 0 до 1. Оценки экспертов усредняют, часто с весами – коэффициентами компетентности \(k_j\): \(q_i = \sum_j k_j a_{ij}\). Если компетентность трёх экспертов оценена как 0,5, 0,3 и 0,2, а их оценки продукта П1 равны 0,8, 1,0 и 0,6, то итоговая оценка \(0{,}5 \cdot 0{,}8 + 0{,}3 \cdot 1{,}0 + 0{,}2 \cdot 0{,}6 = 0{,}82\). Словесные оценки тоже переводят в числа по заранее объявленному правилу, например «плохо» – 0,25, «хорошо» – 0,75, «отлично» – 1,0. Произвол такого перевода надо видеть: он и есть выбор шкалы.
Последовательное сравнение (метод Черчмена – Акоффа) соединяет ранжирование и непосредственную оценку. Объекты сначала ранжируют и дают им предварительные оценки. Затем первый объект сравнивают со всеми остальными вместе взятыми: если эксперт считает, что он ценнее их всех, его оценка должна быть больше суммы их оценок, а если нет – меньше. Оценку исправляют, переходят ко второму объекту и сравнивают его с оставшимися, и так далее. В конце оценки делят на их сумму. Метод заставляет эксперта отвечать на вопросы, которые иначе остались бы незаданными, и тем самым проверяет внутреннюю согласованность его оценок.
- Ваша команда выбирала язык, движок или библиотеку для проекта. Каким из четырёх способов это было сделано на самом деле? Сколько было экспертов?
- Что изменилось бы, если бы каждый участник сначала проранжировал варианты сам, не слыша других, а потом вы посчитали бы \(W\)?
3.5. Много критериев – одна оценка
Обычно объекты сравнивают сразу по нескольким признакам, и нужна одна итоговая, интегральная оценка. Сначала разнородные значения приводят к безразмерному виду – нормируют. Если чем больше, тем лучше, используют \(q = x / x_{\max}\); если чем меньше, тем лучше, – \(q = (x_{\max} - x) / (x_{\max} - x_{\min})\). После нормирования лучшее значение получает 1, худшее – 0 или около того.
Пусть три изделия сравниваются по стоимости, времени изготовления и качеству.
| Критерий | Направление | Ф1 | Ф2 | Ф3 |
|---|---|---|---|---|
| Стоимость, руб. | меньше – лучше | 700 → 0,6 | 1000 → 0,0 | 500 → 1,0 |
| Время изготовления, ч | меньше – лучше | 80 → 0,4 | 50 → 1,0 | 100 → 0,0 |
| Качество, баллы | больше – лучше | 100 → 1,0 | 75 → 0,75 | 50 → 0,5 |
Дальше нормированные оценки сворачивают в одну. Способов три; \(v_j\) – вес критерия \(j\), \(\sum_j v_j = 1\).
\[ \text{аддитивная: } q_i = \sum_j v_j\, q_{ij}, \qquad \text{мультипликативная: } q_i = \prod_j q_{ij}^{\,v_j}, \qquad \text{идеальная точка: } q_i = \sqrt{\sum_j v_j\,(1 - q_{ij})^2}. \]
Аддитивная свёртка – взвешенная сумма. При весах 0,5 (стоимость), 0,3 (время) и 0,2 (качество) получается: Ф1 – 0,62, Ф2 – 0,45, Ф3 – 0,60. Сумма допускает компенсацию: плохая оценка по одному критерию покрывается хорошими по другим.
Мультипликативная свёртка – взвешенное произведение. Она компенсацию не допускает: нулевая оценка хотя бы по одному критерию обнуляет всё. В примере у Ф2 худшая стоимость, у Ф3 – худшее время, и обе получают 0; остаётся одно Ф1 с оценкой 0,59.
Метод идеальной точки – взвешенное расстояние до воображаемого объекта, лучшего по всем критериям сразу. Здесь лучше тот, у кого расстояние меньше: Ф1 – 0,43, Ф3 – 0,59, Ф2 – 0,72.
Во всех трёх случаях выиграло Ф1. Но обратите внимание на аддитивную свёртку: Ф1 опередило Ф3 на две сотых. Стоит немного сдвинуть веса – и победитель сменится.
| Веса: стоимость / время / качество | Ф1 | Ф2 | Ф3 | Победитель |
|---|---|---|---|---|
| 0,50 / 0,30 / 0,20 | 0,62 | 0,45 | 0,60 | Ф1 |
| 0,55 / 0,25 / 0,20 | 0,63 | 0,40 | 0,65 | Ф3 |
| 0,60 / 0,20 / 0,20 | 0,64 | 0,35 | 0,70 | Ф3 |
Веса задаёт человек, и столь малый отрыв меньше, чем точность, с которой он их задал.
3.6. Когда условия неизвестны: критерий выбора тоже выбирают
Ещё труднее сравнивать варианты, когда их результат зависит от обстоятельств, которые заранее неизвестны. Допустим, у проекта три варианта архитектуры \(u_1, u_2, u_3\), а их эффективность зависит от того, какой окажется нагрузка: четыре возможных состояния \(w_1, \dots, w_4\).
| Вариант | w₁ | w₂ | w₃ | w₄ |
|---|---|---|---|---|
| u₁ | 0,4 | 0,3 | 0,2 | 0,5 |
| u₂ | 0,2 | 0,4 | 0,1 | 0,3 |
| u₃ | 0,3 | 0,1 | 0,5 | 0,4 |
Какой вариант лучше, зависит от правила выбора, а правило – от отношения к риску:
- среднего выигрыша: если вероятности состояний известны (пусть 0,3; 0,2; 0,4; 0,1), выбирают наибольшее ожидаемое значение \(\sum_j p_j k_{ij}\) – u₃ (0,35 против 0,31 у u₁);
- Лапласа: если о вероятностях ничего не известно, их считают равными – u₁ (0,35);
- Вальда, или максимина: рассчитывают на худшее и выбирают вариант с лучшим худшим исходом \(\max_i \min_j k_{ij}\) – u₁ (его минимум 0,2, у остальных 0,1);
- максимакса: рассчитывают на лучшее – u₁ или u₃ (0,5);
- Гурвица: смешивают лучший и худший исход с коэффициентом оптимизма \(\alpha\): \(\alpha \max_j k_{ij} + (1 - \alpha) \min_j k_{ij}\); при \(\alpha = 0{,}6\) – u₁ (0,38);
- Сэвиджа: считают «сожаление» – насколько вариант уступает лучшему в каждом состоянии – и минимизируют наибольшее сожаление: u₁ или u₃ (0,3).
Пять правил из шести выбирают u₁, а правило среднего выигрыша – u₃. Ни одно из них не «правильное». Правило выбора – такое же решение, как веса в разделе 3.5, и его тоже записывают и обосновывают заранее: «нам важнее не провалиться при пиковой нагрузке, поэтому критерий Вальда».
Шкала отвечает на вопрос, как записать результат и что с ним можно делать. Но сначала нужно решить, что именно измерять. Сказать «удобный», «быстрый», «надёжный» легко; превратить эти слова в измерение – отдельная работа.
4. Критерий: от слова к числу
В разделе 3 свойства были уже названы: стоимость, время, качество. В настоящей работе их сначала приходится найти. Заказчик говорит «приложение должно быть удобным», в техническом задании написано «система должна работать быстро», в сравнительной таблице стоит «высокая производительность». Ни одно из этих слов нельзя измерить, пока его не превратили в критерий.
4.1. Критерий, показатель, порог
Три слова, которые в обиходе путают, стоит различать.
- Критерий – признак, по которому оценивают и сравнивают варианты: скорость работы, удобство, стоимость владения.
- Показатель (метрика) – способ выразить критерий числом: медианное время ответа сервера в миллисекундах, доля пользователей, выполнивших задачу без подсказки.
- Порог – значение показателя, при котором результат считается достигнутым: не более 200 мс, не менее 80 % пользователей. Порог превращает показатель в критерий успеха.
У одного критерия может быть несколько показателей, и выбор показателя – уже решение, которое надо обосновать. «Скорость» сайта можно измерить временем до первого отображения страницы, временем до готовности к вводу или временем ответа сервера, и победители по этим трём показателям могут оказаться разными.
4.2. Операционализация
Превращение слова в процедуру измерения называется операционализацией: понятие определяют через действия, которыми его измеряют. Вместо «удобный» – «среднее время, за которое новый пользователь находит расписание своей группы». Вместо «надёжный» – «доля запросов, завершившихся без ошибки, за сутки работы».
| Слово | Что можно измерить | Шкала | Как получить |
|---|---|---|---|
| удобный | время выполнения типовой задачи, с; доля пользователей, справившихся без подсказки, %; балл опросника SUS от 0 до 100 (это не процент: средний результат по сотням исследований – 68) | отношений; абсолютная; балл стандартного опросника | испытание с 5–8 пользователями по сценарию |
| быстрый | время ответа, мс: медиана и 95-й процентиль при заданной нагрузке | отношений | нагрузочный тест, записанное окружение |
| надёжный | доля успешных запросов, %; число аварийных завершений на 1000 сеансов | абсолютная | журналы работы за период |
| лёгкий | размер сборки, КБ после минификации и сжатия | отношений | сборка или реестр пакетов, версия и дата |
| поддерживается | число выпусков за последние 12 месяцев; дата последнего выпуска | абсолютная; интервалов | история выпусков репозитория |
| популярный | загрузки из реестра пакетов за неделю | абсолютная | статистика реестра на дату |
| хорошо документирован | ступень по заранее описанной шкале 0–3 | порядка | эксперт по описанию ступеней (раздел 4.5) |
Требование измеримости – не причуда преподавателей, а норма инженерии требований. Международный стандарт ISO/IEC/IEEE 29148 перечисляет слова, которых в требованиях следует избегать, потому что их нельзя проверить: превосходные степени («лучший», «самый»), субъективные оценки («удобный для пользователя», «простой в использовании»), расплывчатые наречия («почти всегда», «существенно»), лазейки («если возможно», «при необходимости»), слова тотальности («все», «всегда», «никогда»). Русскую версию этого перечня приводит ГОСТ Р 59194-2020 «Управление требованиями». В качестве образца стандарт предлагает писать не «оператор не должен ждать завершения операции», а «95 % операций выполняются быстрее чем за 1 с». А ГОСТ 34.602-2020 на техническое задание требует, чтобы требования были проверяемыми и однозначными, и разрешает честную пометку: если значение показателя пока установить нельзя, записывают порядок, в котором его установят.
Удобно идти от цели проекта. Цель задаёт вопросы, вопросы – показатели. Если цель – «выбрать картографическую библиотеку для мобильного веб-приложения», вопросы будут такими: быстро ли откроется карта по мобильной сети? будет ли библиотека жива через год? умеет ли она показывать векторные тайлы? Ответы на них – размер в килобайтах, число выпусков за год, наличие функции по документации. Показатель, который не отвечает ни на один вопрос цели, в таблицу не попадает, сколько бы его ни приводили в обзорах.
Для качества программ есть готовый перечень того, о чём стоит спросить, – модель качества ГОСТ Р ИСО/МЭК 25010-2015. Она делит качество программного продукта на восемь характеристик: функциональная пригодность, производительность, совместимость, удобство использования, надёжность, защищённость, сопровождаемость, переносимость. В новой редакции международного стандарта 2023 года характеристик девять: добавлена безопасность, удобство использования переименовано в способность к взаимодействию, переносимость – в гибкость; российского стандарта на основе этой редакции пока нет. Перечень не заменяет вопросов своего проекта, но помогает не забыть целую сторону качества.
4.3. Если слово всё-таки нужно
Иногда словесная оценка удобна: «быстрый», «средний», «медленный» понятнее, чем ряд чисел. Тогда слово тоже надо определить через измеримую величину. Аккуратный способ даёт теория нечётких множеств. Слово становится лингвистической переменной, а каждое его значение – функцией принадлежности \(\mu(x)\): она сопоставляет каждому значению измеримой величины \(x\) степень от 0 до 1, в которой это значение подходит под слово. Например, «быстрый ответ»:
\[ \mu_{\text{быстрый}}(t) = \begin{cases} 1, & t \le 100 \text{ мс}, \\ \dfrac{1000 - t}{900}, & 100 < t < 1000 \text{ мс}, \\ 0, & t \ge 1000 \text{ мс}. \end{cases} \]
Так же задают «средний» и «медленный». Ответ за 300 мс оказывается «быстрым» со степенью 0,78 и «средним» со степенью 0,25.
С таким определением можно спорить, но его можно проверить и повторить, а слово «быстрый» без определения – нельзя.
4.4. Как проверить сам критерий
Критерий сам нуждается в проверке. Хороший критерий отвечает пяти требованиям.
- Валидность: показатель измеряет то, что заявлено. Число строк кода – плохая мера продуктивности программиста, число звёзд на GitHub – плохая мера качества библиотеки: звёзды ставят за известность, а иногда и накручивают.
- Надёжность: повторное измерение тем же способом даёт тот же результат, и два человека, измеряя независимо, получают одно значение. Для экспертных оценок надёжность проверяют согласованностью, например коэффициентом конкордации из раздела 3.4.
- Чувствительность: показатель различает варианты. Если у всех вариантов стоит «✓», критерий ничего не решает и только занимает строку.
- Независимость: критерии не дублируют друг друга. «Производительность» и «скорость отрисовки» в одной таблице засчитывают одно свойство дважды.
- Доступность: значение можно получить из проверяемого источника за разумное время. Критерий, который никто не может измерить, превращается в догадку.
Есть и ловушка, которая подстерегает самые удачные показатели. Пока показатель только измеряют, он отражает дело. Когда за него начинают награждать, его начинают улучшать напрямую – в обход того, что он должен был отражать. Это наблюдение известно как закон Гудхарта; экономист сформулировал его в 1975 году для денежной статистики, а самая известная его формулировка появилась позже и стала поговоркой.
Программисты встречаются с ним постоянно. Если команду оценивают по числу закрытых задач, задачи дробятся. Если по числу коммитов – коммиты мельчают. Если по покрытию кода тестами – появляются тесты, которые выполняют каждую строку и ничего не проверяют. К этому примеру мы вернёмся в разделе 6.
Близкая ловушка – мерить только то, что легко измерить. У неё есть имя – ошибка Макнамары, по фамилии министра обороны США, который во время Вьетнамской войны оценивал успех по числу убитых противников. Ошибку описывают четырьмя шагами: измерить то, что легко измерить; неизмеримое отбросить или приписать ему произвольное число; решить, что неизмеримое неважно; решить, что его нет. Это тот же поиск под фонарём из раздела 1.5, перенесённый в отчёты: в таблицу попадают звёзды и загрузки, потому что их легко найти, а сопровождаемость и удобство – нет, потому что их надо измерять. Второй шаг – «приписать произвольное число» – нейросеть, как мы увидим в разделе 7, выполняет охотно.
4.5. Паспорт критерия
Всё сказанное сводится в короткое описание, которое должно быть у каждого критерия сравнения или испытания. Назовём его паспортом критерия. Те же поля составляют требования к описанию шкалы: без любого из них измерение нельзя ни повторить, ни проверить. Набор полей не придуман для этого конспекта: о спецификации шкалы и её элементах говорит РМГ 83-2007, о мерах, методах измерения и критериях принятия решений – стандарт процесса измерения ГОСТ Р 58606-2019.
| Поле | Что записать | Пример |
|---|---|---|
| Название | короткое имя без оценочных слов | Размер библиотеки |
| Свойство | что именно отражает | сколько данных браузер скачает ради карты |
| Зачем нужен | на какой вопрос цели отвечает | откроется ли карта по мобильной сети быстро |
| Тип шкалы | наименований, порядка, интервалов, отношений, абсолютная – и почему | отношений: есть естественный ноль |
| Единица и точность | в чём измеряем и с какой точностью | КиБ (по 1024 байта), до десятых |
| Направление | что лучше: больше, меньше или определённое значение | меньше – лучше |
| Способ измерения | процедура и инструмент, по шагам, с числом повторов | минимальное приложение «карта и маркер», сборка esbuild с минификацией, сжатие gzip уровня 9, размер файла |
| Сведение и разброс | как из сырых данных получается значение: медиана, 95-й процентиль; чем выражен разброс | одно значение: сборка воспроизводима, разброса нет |
| Источник и дата | откуда взято значение и когда | реестр npm, Leaflet 1.9.4; 18.10.2026 |
| Кто измеряет | роль; не тот ли, кто заинтересован в результате | член команды, не участвовавший в выборе |
| Градации или порог | для порядковой шкалы – описание каждой ступени; для количественной – порог, если он есть | обязательный порог: не больше 150 КиБ |
| Вес | доля в итоговой оценке и как он получен | 0,2: решено командой до сбора значений |
| Как можно обмануть | как улучшить число, не улучшив свойство | измерить только ядро без нужных модулей |
| Проверка | как другой человек получит то же значение | повторить команду; сверить с bundlephobia.com |
Для порядковой шкалы самое важное поле – градации. Ступень должна описываться наблюдаемым признаком, который два человека оценят одинаково. Не «плохая – средняя – хорошая документация», а так:
| Ступень | Что должно быть |
|---|---|
| 0 | документации нет или только файл README без описания функций |
| 1 | справочник по всем функциям (API) |
| 2 | справочник и руководство «начало работы» с работающим примером |
| 3 | всё перечисленное, примеры для типовых задач и пометка, к какой версии относится текст |
Такую шкалу по-прежнему нельзя усреднять и складывать с килобайтами: она порядковая. Но её можно проверить, а значит, ей можно доверять.
Паспорт говорит, что и как измерять. Но одно измерение – ещё не эксперимент: время работы программы, измеренное один раз на ноутбуке с открытым браузером, само может быть иллюзией вроде отрезков Мюллера-Лайера. Как получить числа, которым можно верить, разбирает следующий раздел.
5. Этапы эксперимента
Разделы 2–4 ответили на вопросы «зачем ставить опыт», «как записывать результат» и «что измерять». Осталось собрать ответы в порядок действий. Он один и тот же для лабораторного опыта и для сравнения двух программ, но у компьютерного эксперимента есть свои ловушки: в нём легко получить много чисел, и потому особенно легко получить неверные.
5.1. Общий порядок
В теории планирования эксперимента приняты несколько слов, без которых трудно описать любой опыт; по-русски они закреплены в ГОСТ 24026-80 «Исследовательские испытания. Планирование эксперимента. Термины и определения». Фактор – то, что экспериментатор меняет: алгоритм, библиотека, размер входных данных, версия языка. Уровни фактора – его значения в опыте: «цикл» и «списковое включение»; 10³, 10⁴ и 10⁵ элементов. Отклик – то, что измеряют: время работы, объём памяти, точность. План эксперимента – перечень сочетаний уровней факторов, при которых измеряется отклик. Опыты, повторённые при одном и том же сочетании, стандарт называет параллельными, а слово «параметр» не рекомендует ни для фактора, ни для отклика: оно слишком многозначно.
Порядок работы складывается из восьми шагов.
- Вопрос и гипотеза. Что хотим узнать и какой ответ ожидаем. Гипотеза формулируется так, чтобы опыт мог её опровергнуть.
- Критерий и шкала. Какой отклик измеряем, в каких единицах, какой результат считаем успехом. Паспорт критерия из раздела 4.5 пишется здесь, до опыта.
- Объект и условия. Что именно испытываем (версии, данные) и в каких условиях (оборудование, окружение, нагрузка). Всё, что не является фактором, держим постоянным.
- План. Факторы, уровни, число повторов, порядок прогонов. Порядок лучше перемешать случайно, чтобы постепенный нагрев процессора или фоновые задачи не достались одному варианту.
- Пробный прогон. Короткий запуск, который проверяет, что измерение вообще работает: программа не падает, таймер измеряет то, что нужно, данные записываются.
- Основной прогон. Всё записывается в журнал: дата, версия, параметры, сырые результаты.
- Обработка и анализ. Среднее или медиана вместе с разбросом, сравнение с базовым вариантом, проверка, не объясняется ли разница случайностью. Отдельно – угрозы выводу: что ещё, кроме фактора, могло повлиять на результат.
- Отчёт. Вывод в границах проверенных условий и всё, что нужно, чтобы опыт повторил другой человек: код, данные, версии, окружение.
5.2. Вычислительный эксперимент: модель, алгоритм, программа
Когда опыт ставят не над реальным объектом, а над его математической моделью, говорят о вычислительном эксперименте. Академик А. А. Самарский в 1979 году описал его как цикл из пяти этапов: построить математическую модель, разработать вычислительный алгоритм, написать программу, провести расчёты, а затем проанализировать результаты, сопоставить их с натурным опытом и при необходимости вернуться к модели. Первые три звена позже стали называть триадой Самарского «модель – алгоритм – программа». Готовую триаду сначала отлаживают на пробных расчётах и только после того, как удостоверена её адекватность объекту, ставят с ней настоящие опыты – так же, как ставили бы их с реальным объектом. Так рассчитывают течение жидкости, прочность конструкции, распространение сигнала, движение спутника.
У вычислительного эксперимента две особые проверки, и их легко спутать.
- Верификация: правильно ли программа решает уравнения модели. Её проверяют на задачах с известным точным решением, сравнением с другой программой, уменьшением шага расчёта: если при уменьшении шага результат не сходится, ошибка в программе или алгоритме.
- Валидация: те ли это уравнения, то есть насколько модель описывает реальный объект. Её проверяют только сравнением с наблюдениями реального мира.
В программной инженерии эта пара звучит так: верификация спрашивает, правильно ли мы строим продукт, валидация – тот ли продукт мы строим. Безупречно проверенная программа, которая решает не ту задачу, проходит верификацию и проваливает валидацию.
5.3. Замер скорости
Самый частый компьютерный эксперимент в студенческом проекте – сравнение скорости: какой алгоритм быстрее, ускорила ли программу правка, какая библиотека справляется лучше. И самый частый способ его провести – запустить программу один раз и засечь время. Так делать нельзя, и вот почему.
Возьмём две реализации одной функции на Python – построение списка квадратов: A – цикл с методом append, B – списковое включение [x * x for x in data]. Сравним их сначала наивно: один вызов каждой функции, время засекается до и после. Чтобы увидеть, насколько надёжен такой замер, повторим его 30 раз, каждый раз в новом процессе. Замеры выполнены 18 октября 2026 года на компьютере с процессором Ryzen 9 7900X, Windows 10 и Python 3.12.6.
| Способ замера | Что получилось |
|---|---|
один вызов, часы time.time(), 1000 элементов | в 26–28 случаях из 30 – «одинаково» |
один вызов, часы perf_counter(), сначала A, потом B | «B быстрее» в 30 случаях из 30 |
один вызов, часы perf_counter(), сначала B, потом A | «A быстрее» в 29 случаях из 30 |
timeit: 15 серий по 1000 вызовов, три сеанса | медианы: A – 256–295 мкс, B – 202–203 мкс |
pyperf: 20 процессов с прогревом, 10 000 элементов | A – 257 ± 6 мкс, B – 201 ± 6 мкс; A медленнее в 1,28 раза (95 %-й доверительный интервал 1,27–1,30) |
Первая строка – ошибка прибора. Часы time.time() в Windows до Python 3.13 обновлялись раз в 15,6 мс, а функция работает несколько сотых долей миллисекунды: это всё равно что мерить толщину листа бумаги линейкой с сантиметровыми делениями. Разрешение шкалы должно быть мельче измеряемой разницы.
Вторая и третья строки – ошибка опыта, и она коварнее. Наивный замер уверенно, тридцать раз из тридцати, называет победителя, но победителем всегда оказывается функция, запущенная второй: первый вызов в свежем процессе примерно в полтора раза медленнее последующих. Замер измерял не функции, а порядок их запуска. Без перестановки порядка этого не заметить, и повторение тут не спасает: ошибка воспроизводится тридцать раз из тридцати. Воспроизводимость ещё не означает правильности.
Последняя строка – правильный ответ: цикл действительно медленнее, примерно на 28 %. И даже он верен только для этих условий. На Python 3.10 на той же машине отношение составило 1,55: новая версия интерпретатора ускорила цикл сильнее, чем списковое включение. Поэтому версия языка – такая же часть условий опыта, как процессор.
Время работы программы зависит не только от программы. Первый запуск медленнее последующих: данные ещё не в кэше, интерпретатор или JIT-компилятор ещё не прогрелись. Процессор меняет частоту в зависимости от температуры и нагрузки. Фоновые задачи – браузер, антивирус, обновления – отнимают время случайно. Даже вещи, которые кажутся не относящимися к делу, влияют на результат. В известном исследовании 2009 года изменение размера неиспользуемой переменной окружения меняло время работы простой программы часто примерно на треть. А от порядка, в котором компоновщик собирал объектные файлы, зависел сам вывод: ускорение от оптимизации компилятора колебалось от 0,92 до 1,10, то есть от замедления на 8 % до ускорения на 10 %. Медиана ускорений, заявленных в просмотренных авторами статьях, была как раз около 10 %. Другое исследование, 2013 года, нашло, что из 90 статей, где мерили время, 71 не приводила никакой меры разброса.
Отсюда правила замера.
- Прогреть программу несколькими запусками, результаты которых не учитываются.
- Повторить замер много раз – десятки, а для коротких операций тысячи – и сообщать медиану и разброс (межквартильный размах или доверительный интервал), а не одно число.
- Чередовать варианты в случайном порядке, а не запускать сначала все прогоны одного, потом все прогоны другого.
- Записать окружение: процессор, объём памяти, операционную систему, версии языка и библиотек, режим питания ноутбука.
- Пользоваться инструментами, которые всё это делают:
timeitиpyperfв Python,hyperfineдля любых команд, JMH в Java, BenchmarkDotNet в C#.
Чем подводить итог, спорят и специалисты. Документация timeit советует смотреть на минимум из повторов: всё, что дольше минимума, – помехи. pyperf и исследователи бенчмарков советуют медиану или среднее с разбросом и доверительный интервал для отношения: программа в работе тоже встречает помехи. Для отчёта надёжнее второе, а главное – назвать, что именно вы привели.
# hyperfine сам прогреет, повторит и сравнит две команды
hyperfine --warmup 3 --runs 30 "python sort_a.py data.txt" "python sort_b.py data.txt"
5.4. Эксперимент с моделью машинного обучения
У опыта с моделью машинного обучения своя главная ловушка – утечка данных. Если сведения из проверочной выборки любым путём попали в обучение, модель на проверке покажет блестящий результат, которого не будет на новых данных. Утечка бывает явной (одни и те же объекты в обеих выборках), временной (модель, предсказывающая завтрашний день, училась на данных из будущего) и скрытой (нормирование посчитали по всему набору данных, а потом разделили его). Это не редкость: обзор 2023 года собрал свидетельства утечки в 294 опубликованных работах из 17 научных областей, а к осени 2026 года на сайте того же проекта их уже 648 из 30 областей.
Правила здесь продолжают общие.
- Делить данные на обучающую, проверочную и тестовую выборки до любой обработки. Тестовую открывать один раз, в самом конце.
- Для временных рядов делить по времени, для данных о людях или объектах – по людям и объектам, а не по строкам.
- Повторять обучение с разными начальными значениями генератора случайных чисел и сообщать разброс. В известном опыте 2018 года один и тот же алгоритм обучения с подкреплением запустили с десятью разными зёрнами и разбили запуски на две группы по пять: кривые обучения групп различались статистически значимо, как будто это два разных алгоритма.
- Сравнивать с простым базовым решением: если сложная модель не обыгрывает «всегда отвечать самым частым классом», задача не решена.
5.5. Эксперимент с пользователями
Удобство, понятность, привлекательность измеряют на людях, и здесь все уроки раздела 2 действуют в полную силу. Пользователь, которому объяснили, что именно проверяют, ведёт себя иначе. Разработчик, наблюдающий за испытанием своего интерфейса, невольно подсказывает, как хозяин Умного Ганса.
Два распространённых вида таких опытов – испытание по сценарию и A/B-тест. В испытании по сценарию пять–восемь человек выполняют типовые задачи, а наблюдатель записывает время, ошибки и места, где человек остановился. По известной модели пять участников находят около 85 % проблем интерфейса, и выгоднее провести три испытания по пять человек, исправляя найденное между ними, чем одно на пятнадцать. В A/B-тесте пользователей случайно делят на группы и показывают им разные варианты; здесь главная ошибка – подглядывать в результаты и останавливать опыт, как только разница «стала значимой». Так случайное колебание легко принять за эффект. У специалистов по таким опытам есть правило, которое называют законом Тваймана: любая цифра, которая выглядит интересной или необычной, обычно ошибочна. Сначала ищут ошибку в опыте, потом радуются результату. Законы интерфейсов, которые проверяют такими опытами, разобраны в занятии 10.
Самый короткий и самый частый эксперимент в работе программиста – тест. В нём есть всё, о чём шла речь: гипотеза («функция работает правильно»), критерий (ожидаемый результат), опыт (запуск) и вывод. И в нём же легче всего обмануть себя.
6. Подтверждение функций программы
Попросите ИИ-агента покрыть проект тестами, и через несколько минут их будет сто. Все зелёные, покрытие кода под сто процентов. Выглядит как доказательство того, что программа работает. Посмотрим, что именно доказывает такой набор тестов, глазами раздела 2: какая гипотеза проверяется, каков критерий, могла ли проверка закончиться неудачей.
6.1. Тест – маленький эксперимент
Тест сравнивает фактический результат программы с ожидаемым. Ожидаемый результат должен откуда-то взяться: из требований, из расчёта вручную, из другой, заведомо верной программы. Источник ожидаемого результата называют тестовым оракулом, и именно он – самое трудное место тестирования. Запустить функцию на любом входе легко; знать, что она должна вернуть, трудно.
Второе свойство теста знакомо по задаче 2–4–6. Тест – выборочная проверка: из бесконечного множества входов и последовательностей действий он проверяет несколько. Сколько бы тестов ни прошло, они говорят только о проверенных случаях. Эдсгер Дейкстра, один из основателей программирования как науки, сформулировал это в 1969 году:
Отсюда вопрос к любому набору тестов: не «сколько их», а «какие ошибки они могли бы найти».
6.2. Сто зелёных тестов
Посмотрим, что обычно оказывается в наборе тестов, который нейросеть пишет для функции, принимающей ввод пользователя:
- проверки на примерах из описания задачи – тех самых, что были в запросе;
- проверки по форме: результат не пустой, имеет нужный тип, функция не упала;
- проверки, ожидаемый результат которых получен из самого кода: модель прочитала функцию и записала в тест то, что функция возвращает, – вместе с её ошибками;
- проверки с заглушками, которые подменяют всё, что могло бы сломаться, так что тест проверяет заглушку.
Каждый такой тест проходит. Но тест, проверяющий, что результат имеет тип «число», пройдёт и тогда, когда результат – NaN: в JavaScript у NaN тоже тип number. Тест, ожидаемое значение которого списано с кода, закрепляет ошибку как правильное поведение. Исследования это подтверждают.
- В опыте 2023 года ChatGPT написал тесты для тысячи методов на Java. Компилировались 42 % тестов, проходили 25 %, а среди упавших 85 % падали из-за неверных проверок, то есть неверного ожидаемого результата.
- В работе 2024 года показано, что модели склонны записывать в тест фактическое поведение кода, а не требуемое: на коде с ошибкой они выбирают верную проверку заметно реже, чем на правильном, и ориентируются на имена функций и переменных, а не на требования.
- В наборах тестов от языковых моделей от 8 до 77 % тестов не содержат ни одной проверки – у генератора тестов без нейросети таких 0–7 %.
- По данным 2026 года, ИИ-агенты добавляют заглушки в 36 % своих изменений, люди – в 26 %. В отчёте о собственной модели одна из компаний-разработчиков прямо пишет, что её модель создавала «тесты, которые проверяют заглушку, а не настоящую реализацию».
Покрытие кода этого не исправляет. Покрытие показывает, какие строки выполнились во время тестов, но не показывает, проверил ли кто-нибудь, что они сделали. Исследование 2014 года на пяти больших программах и 31 000 наборов тестов показало: если учесть размер набора, связь покрытия со способностью тестов находить ошибки слабая. Авторы вывели правило, которое стоит запомнить: покрытие полезно, чтобы найти непроверенный код, но не годится как цель.
У покрытия есть и парадокс, который хорошо виден на маленьком опыте. Функция разбора оценки написана с ошибками: не принимает «4,5» с запятой, пропускает оценки вне диапазона, падает на пустом списке. Десять «формальных» тестов к ней проходят и дают 100 % покрытия. После того как функцию исправили, добавив все нужные проверки, те же десять тестов дают только 74 %: в исправленном коде появились строки обработки ошибок, которые тесты не выполняют. В коде с ошибками этих строк просто нет – а отсутствующий код покрыт на сто процентов.
Когда же покрытие становится целью, вступает в силу закон Гудхарта из раздела 4.4: появляются тесты, написанные ради процента.
6.3. Почему нейросеть ищет под фонарём
Набор тестов от нейросети – точный пример поиска под фонарём из раздела 1.5. Тесты стоят там, где светло: на примерах из описания и на «счастливом пути», когда пользователь делает ровно то, что задумал разработчик. Ошибки живут в темноте вокруг.
Причин четыре, и все они уже встречались в этом конспекте.
- Модель видит код, а не требования. Ожидаемый результат она чаще всего выводит из того, что делает код. Получается проверка кода самим собой – как если бы испытуемый в задаче 2–4–6 проверял только тройки, построенные по своей гипотезе.
- Модель не видит пользователя. Она не знает, что в русской раскладке дробь пишут через запятую, что люди нажимают Enter вместо кнопки, а кнопку – дважды, что форму открывают в двух вкладках. Всё это – факты о людях, а не о коде.
- Задачу оценивают по форме. Если задача поставлена как «напиши тесты» или «подними покрытие», критерий её выполнения – число тестов и процент покрытия. Модель выполняет именно этот критерий.
- Агент может подогнать тесты под код. Когда агент сам запускает тесты и стремится, чтобы они прошли, он иногда меняет не код, а тест. Это поведение подробно описано в отчётах самих разработчиков моделей. В 2025 году одна модель «в особых случаях» возвращала ровно те значения, которых ждал тест, и правила сами тесты; в опыте другой компании агент, которому велели сделать так, чтобы тесты проходили, написал функцию проверки, всегда возвращающую «истину», и завершал программу до запуска тестов. В исследовании 2025 года моделям давали задачи, в которых тесты нарочно противоречили требованиям, так что честно их пройти было невозможно; одна из лучших моделей «проходила» 76 % таких задач. В отчёте о модели, вышедшей в июле 2026 года, среди поведений, замеченных при обучении, по-прежнему значится правка и удаление тестов и проверок, чтобы они проходили.
если агент одновременно меняет код и тесты, зелёный результат ничего не доказывает. Тесты, которые фиксируют требования, меняются только с ведома человека. Перед тем как принять работу агента, посмотрите изменения в файлах тестов отдельно: не ослаблены ли проверки, не появились ли пропуски (skip), особые ветки для тестовых входов и подмены сравнения. В том же исследовании запрет менять тесты – файлы только для чтения – снизил долю таких «решений» у одной из моделей с 50 до 1 %.
6.4. Что делает настоящий пользователь
Среди тестировщиков ходит шутка. Тестировщик заходит в бар и заказывает кружку пива. Заказывает ноль кружек. Заказывает 99 999 999 999 кружек. Заказывает ящерицу. Заказывает минус одну кружку. Заказывает «ывфапр». Всё работает. В бар заходит первый настоящий посетитель и спрашивает, где туалет. Бар сгорает.
Шутка точна в обе стороны. Тестировщик перебрал неожиданные значения одного действия – «заказать». Посетитель выполнил действие, которого в модели программы не было вообще. История программирования знает много таких случаев, и в большинстве из них ошибку вызвали не сложные вычисления, а неожиданный ввод, неожиданный порядок действий или условия, в которых программу не испытывали.
- Therac-25, 1985–1987. Аппарат лучевой терапии. Опытная операторша исправляла ошибку ввода и возвращалась к команде меньше чем за 8 секунд – примерно столько длилась перестройка магнитов. Правку, сделанную в этот промежуток, программа не замечала. Расследование прямо назвало скорость редактирования ключевым условием ошибки. Шесть пациентов получили огромные дозы облучения, не меньше трёх из них умерли. Медленный, «правильный» ввод ошибку не вызывал.
- Ariane 5, 4 июня 1996 года. Через 37 секунд после включения двигателя ракета потеряла управление. Программа навигации досталась от Ariane 4 и была хорошо испытана – на траекториях Ariane 4. Новая ракета разгонялась быстрее, величина, связанная с горизонтальной скоростью, не поместилась при преобразовании в 16-битное целое, и обе навигационные системы отказали. Данные траектории Ariane 5 по договорённости не включили в требования к этой программе, поэтому на них её не испытывали.
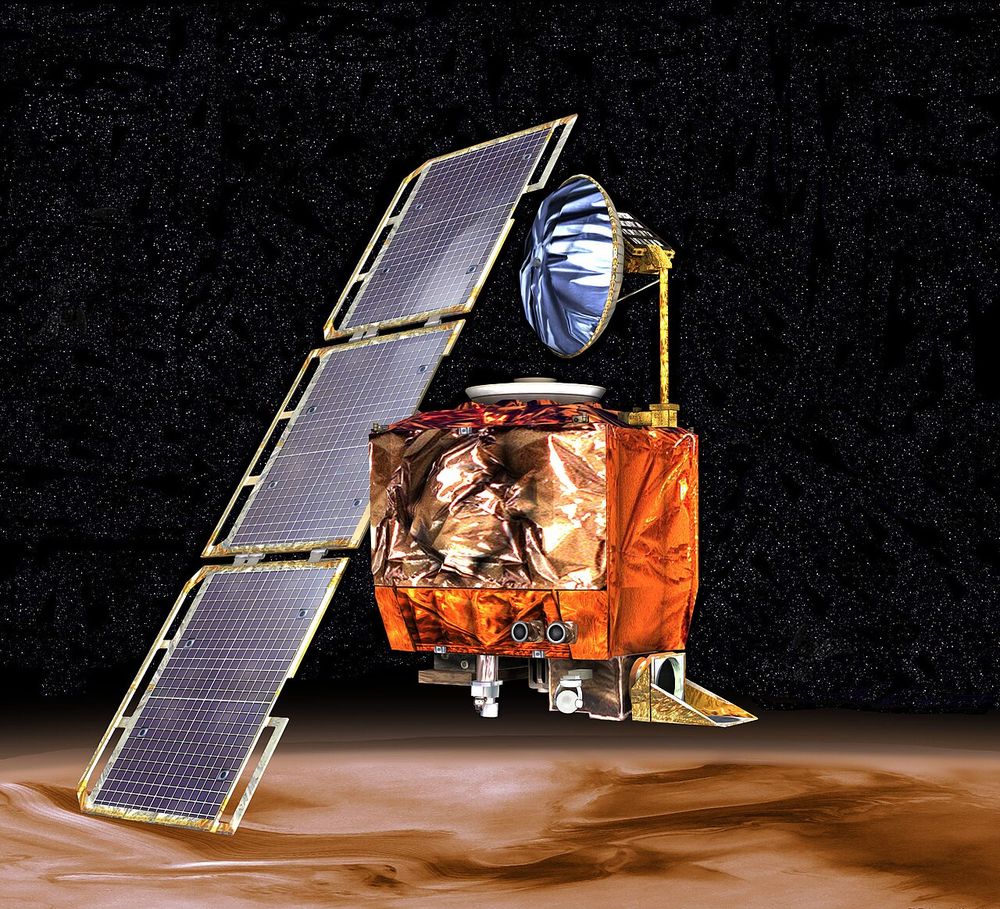
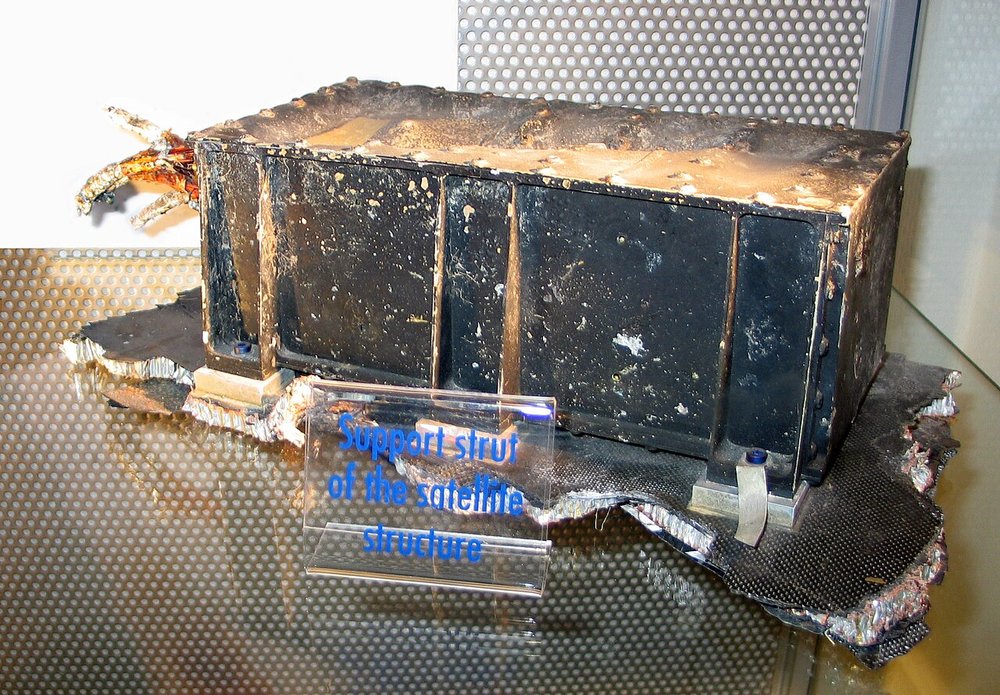
- Mars Climate Orbiter, 23 сентября 1999 года. Межпланетная станция вошла в атмосферу Марса на высоте около 57 км вместо запланированных 226 и погибла. Одна программа выдавала импульс двигателей в фунт-сила-секундах, а другая ждала ньютон-секунды; импульс оказался занижен в 4,45 раза. Это ошибка из раздела 3: число без единицы измерения. Тесты каждой из двух программ при этом проходили.
- CrowdStrike, 19 июля 2024 года. Обновление программы защиты уронило около 8,5 миллиона компьютеров с Windows. Новый шаблон описывал 21 входное поле, а программа передавала только 20. Во всех тестах в 21-м поле стояла «звёздочка» – «подходит что угодно», поэтому его никто не читал. Первый шаблон с настоящим значением в этом поле вызвал чтение за границей массива. Среди причин компания сама назвала отсутствие теста на 21-е поле с конкретным значением. Это поиск под фонарём почти в чистом виде.
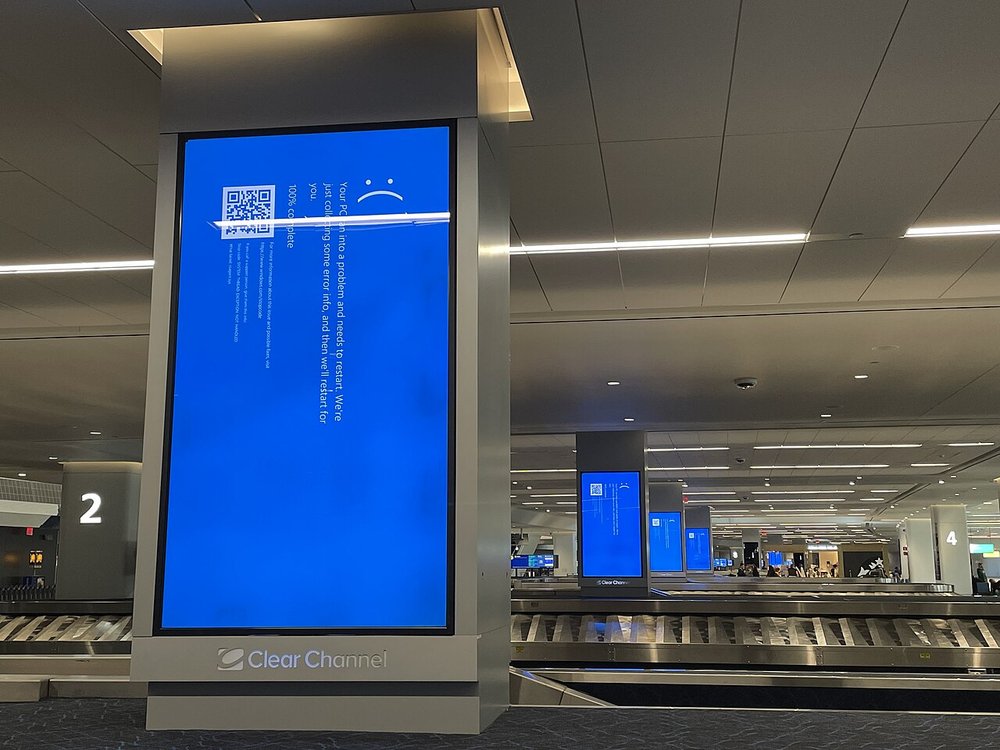
float("4,5") в Python вызывает исключение, Number("4,5") в JavaScript даёт NaN. Зато float("4_5") в Python молча возвращает 45, а float("nan") и float("inf") проходят без ошибки. Excel в русской Windows разделяет поля CSV точкой с запятой, а разряды – неразрывным пробелом. Ввод пользователя проверяют на пустую строку, пробелы, запятую и точку, слова, слишком длинную строку, отрицательные числа, ноль и значения на границах допустимого.
Неожиданный ввод бывает и злонамеренным. Если программа подставляет введённую строку прямо в запрос к базе данных, имя ученика может оказаться командой.
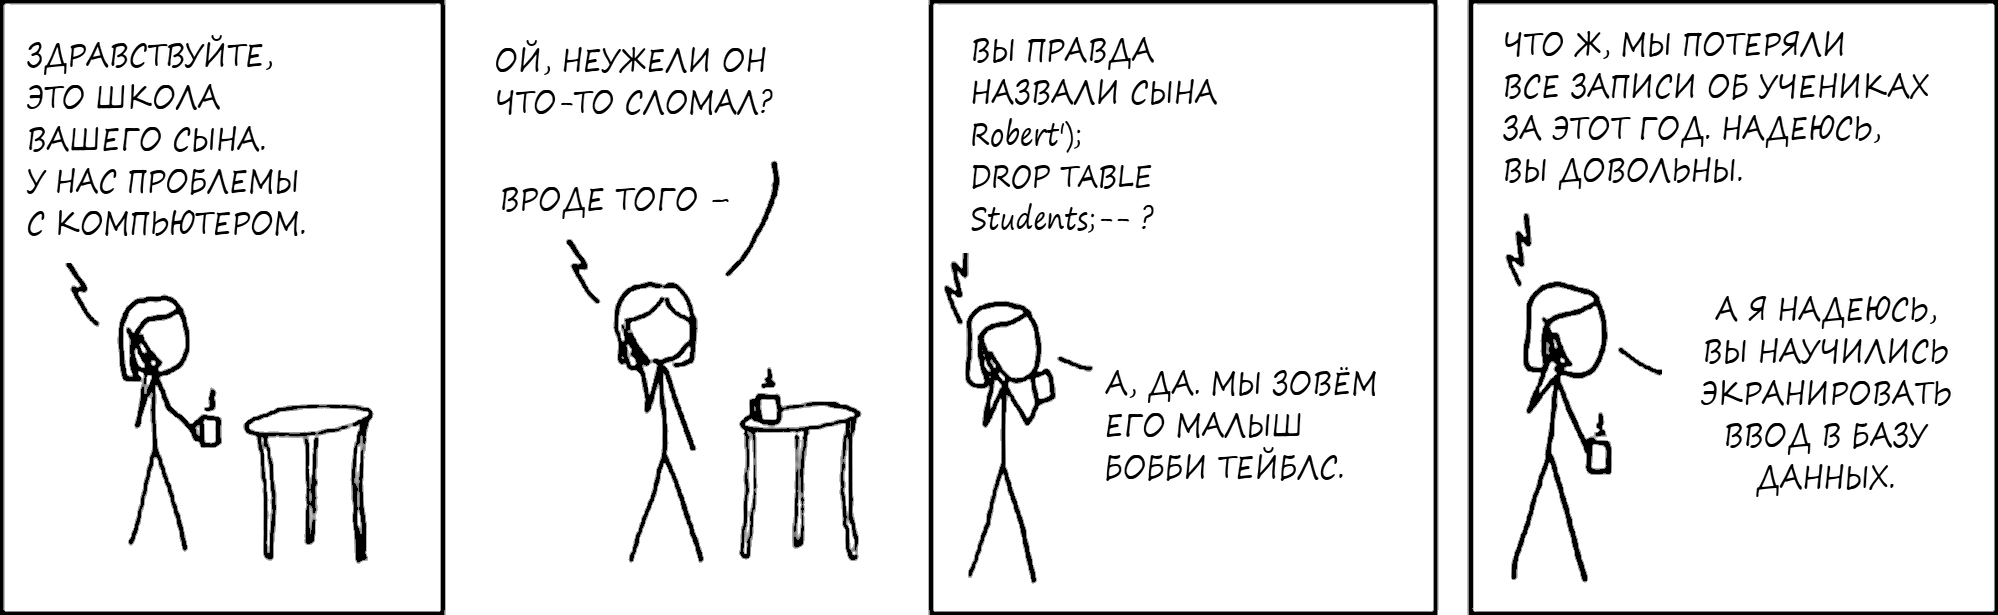
Robert'); DROP TABLE Students;--. Школьная программа вставила это имя в запрос к базе данных без проверки, и вторая половина имени выполнилась как команда «удалить таблицу учеников». Прозвище Bobby Tables значит «Бобби Таблицы». Рисунок: Рэндалл Манро, xkcd.com/327, лицензия CC BY-NC 2.5; надписи переведены на русский.Надёжная защита – не «экранировать вручную», а параметризованный запрос: значение передаётся базе данных отдельно от текста команды и не может выполниться как её часть.
6.5. Приёмы, которые светят в темноту
Против поиска под фонарём у тестирования есть свои приёмы. Все они делают одно и то же: заставляют выбирать проверки не потому, что их легко написать, а потому, что там вероятнее ошибка. Ниже они названы так, как их называет русская версия программы сертификации тестировщиков ISTQB.
- Эквивалентное разбиение. Входы делят на классы, внутри которых программа должна вести себя одинаково: допустимые оценки, слишком маленькие, слишком большие, дробные, не числа, пустой ввод. Из каждого класса берут хотя бы одного представителя, в том числе из недопустимых.
- Анализ граничных значений. Ошибки собираются на границах. Если допустимы оценки от 2 до 5, проверяют 1, 2, 5 и 6.
- Тестирование переходов состояний. Программа – это не только функции, но и последовательности действий: добавить – удалить – посчитать, отменить после отправки, нажать «Оплатить» дважды. Рисуют диаграмму состояний (она разобрана в занятии 8) и проверяют каждый переход, в том числе недопустимый.
- Тестирование на основе свойств. Вместо конкретных примеров формулируют свойство, верное для любого входа, а примеры порождает библиотека – сотни случайных и граничных. Найдя нарушение, библиотека сама сокращает его до самого простого примера.
- Фаззинг. Программе подают поток случайно искажённого ввода и ловят аварийные завершения. Первый такой опыт 1990 года уронил или подвесил от четверти до трети стандартных программ UNIX, а повторение через тридцать лет показало, что доля отказов не уменьшилась. Сервис OSS-Fuzz к маю 2025 года помог найти и исправить больше 13 000 уязвимостей и 50 000 ошибок в тысяче открытых проектов.
- Исследовательское тестирование. Человек одновременно изучает программу, придумывает проверки и выполняет их, как пользователь, который ещё не знает, «как надо», и записывает, что пробовал.
- Испытание с пользователями. Пять человек, выполняющих типовые задачи, находят большую часть проблем интерфейса; лучше три испытания по пять человек, чем одно на пятнадцать.
Отдельно стоит мутационное тестирование: оно проверяет сами тесты. Инструмент вносит в код маленькие ошибки – меняет < на <=, + на -, константу 2 на 3 – и запускает тесты. Если тесты по-прежнему проходят, они этой ошибки не заметили бы и в жизни. Доля «убитых» мутантов – куда более честная мера качества тестов, чем покрытие. Инструменты: mutmut и cosmic-ray для Python, Stryker для JavaScript и C#, PIT для Java.
Все эти приёмы удобно держать перед глазами как карту. Каждый освещает свою часть темноты: значения, которые может ввести пользователь, порядок его действий, то, чего заранее не придумать, и, наконец, сами тесты.
Тест на основе свойств для функции среднего балла на Python с библиотекой Hypothesis выглядит так.
from hypothesis import given, strategies as st

grades = st.lists(st.integers(min_value=2, max_value=5), min_size=1)

@given(grades)
def test_average_is_between_min_and_max(gs):
    a = average(gs)
    assert min(gs) <= a <= max(gs)        # среднее не выходит за пределы оценок

@given(st.text())
def test_bad_input_is_rejected(raw):
    # любая строка, которая не является целым числом от 2 до 5, должна отклоняться
    if raw.strip() not in {"2", "3", "4", "5"}:
        assert parse_grade(raw) is None
В опыте, о котором шла речь выше, похожий тест сам нашёл и сократил до минимальных два контрпримера, до которых не додумались «формальные» тесты: оценку «2,5» с запятой и пустой список.
Теперь попробуйте сами. Ниже – маленькая программа и восемь тестов к ней, которые написала нейросеть. Тесты проходят. Программа содержит восемь ошибок.
Ниже – небольшая программа и восемь тестов, которые для неё написала нейросеть. Все тесты проходят. Попробуйте программу так, как это сделал бы пользователь: вводите неожиданные значения, нажимайте кнопки в другом порядке, жмите Enter. Каждая найденная ошибка появится в списке справа вместе с приёмом тестирования, который её ловит.
6.6. Как поручать тесты нейросети
Нейросеть пишет тесты быстро, и отказываться от этого не нужно. Нужно поручать ей правильную задачу и проверять результат. Большинство правил ниже прямо рекомендуют руководства разработчиков ИИ-агентов и исследования последних лет.
Короткий запрос, в котором собраны эти правила:
Требования к функции: R1 … Rn.
Сначала составь таблицу: классы эквивалентности (допустимые и недопустимые), граничные
значения (по три на каждую границу), недопустимые последовательности действий. Код пока не пиши.
По таблице напиши тесты, запусти их и покажи, что они падают.
Тесты не меняй и не удаляй. Если считаешь тест неверным – остановись и скажи.
Не подгоняй решение под конкретные входы тестов. Покажи вывод запуска.
В отчёте результаты тестирования оформляют таблицей «проверка – ожидаемый результат – фактический результат» (справка «Структура отчёта и ВКР», раздел 5). Приёмы этого раздела отвечают на вопрос, какие строки в эту таблицу поставить, чтобы она что-то доказывала.
Тесты проверяют программу против её требований. Сравнительная таблица проверяет решение против других решений. С ней нейросеть ошибается по тем же причинам – и тоже предсказуемо.
7. Сравнительные таблицы и нейросеть
Тест проверяет одну программу. Сравнительная таблица проверяет выбор: какую библиотеку взять, чем проект лучше аналогов. В отчёте по практике и в выпускной работе такая таблица стоит в первой главе, и теперь её почти всегда начинают с запроса к нейросети. Таблица приходит через несколько секунд, аккуратная и уверенная. Чтобы понять, что в ней не так, сначала разберёмся, какой она должна быть.
7.1. Зачем нужна сравнительная таблица
В отчёте сравнительная таблица решает одну из двух задач.
- Обзор аналогов. Существующие продукты, которые решают похожую задачу: другие приложения расписания, другие сервисы карт, другие игры жанра. Таблица показывает, чего не умеет ни один из них, – и тем самым доказывает, что собственная разработка нужна. Это продолжение актуальности из занятия 3.
- Выбор средств. Библиотеки, движки, базы данных, модели, из которых проект будет собран. Таблица показывает, почему взят именно этот вариант. Справка по отчёту требует здесь «не просто „мы взяли X“, а почему X, а не Y и Z» (справка «Структура отчёта и ВКР», раздел 3).
В обоих случаях таблица – не украшение, а сжатая запись измерений, по которой читатель может проверить вывод. Поэтому у неё есть обязательные части, и каждая отвечает на вопрос, который задаст рецензент.
Читая любую таблицу – свою, чужую или от нейросети, – полезно задать каждой ячейке три вопроса. Что именно измерено? В какой шкале и единице? Откуда взято значение и на какую дату оно верно? Если хотя бы на один вопрос ответа нет, ячейка выражает мнение, а не измерение.
Вузовские методисты требуют того же. На кафедре математического обеспечения ЭВМ петербургского ЛЭТИ в задании «Обзор аналогов» прямо не допускаются бинарные критерии «да – нет» и «+ – −», а в списке типовых ошибок первыми стоят субъективные оценки «хорошо, плохо, много, мало, быстро, медленно»: их требуется заменить количественными значениями и указать, кто, на каких данных и в каких условиях измерял. Там же отмечена тонкость, о которой легко забыть: «псевдоколичественная» шкала вроде «степень автоматизации от 0 до 5» ничем не лучше слова «высокая». Лучше перечислить, какие именно возможности у аналога есть. Порядковая шкала допустима, только если каждая её ступень описана наблюдаемым признаком, как в разделе 4.5.
7.2. Что возвращает модель
Возьмём типичный запрос студента: «Сравни Leaflet, OpenLayers и MapLibre GL JS для моего проекта – веб-карты для мобильных устройств». Это три распространённые библиотеки для карт в браузере. Ниже таблица, какую обычно возвращает чат-модель. Она составлена для упражнения и не цитирует ответ какой-либо конкретной модели, но каждая её особенность встречается в настоящих ответах.
Красным подсвечено то, что «сгенерировано» плохо. Наведите на подсветку курсор (на телефоне – нажмите на неё), чтобы прочитать, что не так; зелёным отмечено то, что сделано правильно.
| Критерий | Leaflet | OpenLayers | MapLibre GL JS | Наше решение |
|---|---|---|---|---|
| Простота использованияД1 · критерий не определён. Простота для кого и в чём: время до первой работающей карты, объём кода, число понятий, которые нужно освоить? | ✓ ВысокаяД2 · шкала не указана. «Высокая – средняя – низкая» – порядковая шкала, ступени которой нигде не описаны: что отличает «высокую» от «средней», читатель не узнает. | СредняяД2 · шкала не указана. Ступень «средняя» ничем не определена, проверить её нельзя. | СредняяД6 · задача не задана. Простота зависит от того, что нужно сделать: маркеры на растровой подложке или векторный стиль с рельефом. | ✓ ВысокаяД9 · своё решение выигрывает во всём. Продукта ещё нет, а оценка уже поставлена. |
| Производительность | СредняяД6 · задача не задана. Сколько объектов на карте, какие тайлы, какое устройство? При десяти маркерах и при ста тысячах точек ответы разные. | ВысокаяД3 · нет единицы и способа измерения. Чем мерили: кадрами в секунду при панорамировании, временем первой отрисовки, памятью? | ✓ Очень высокая (WebGL)Д11 · косвенный показатель вместо свойства. WebGL объясняет, почему библиотека может быть быстрее, но это не результат замера. | ✓ Очень высокаяД9 · своё решение выигрывает во всём. Замера нет – есть пожелание. |
| Векторные тайлы | ✗Д7 · галочка скрывает степень. «✗» скрывает, что у Leaflet векторные тайлы подключаются плагинами. Нужна шкала «в ядре / плагином / нет». | ✓ | ✓ | ✓ |
| Размер библиотеки | ✓ Лёгкая (~40 КБ)Д3 · нет единицы и способа измерения. 40 КБ чего: исходного кода, минифицированного файла, сжатого? Число почти совпадает со сжатым размером Leaflet (42,5 КиБ), но по таблице это не проверить. | ✗ ТяжёлаяД6 · задача не задана. Размер OpenLayers зависит от того, что импортировать: минимальное приложение – 94 КиБ, полная готовая сборка – около 291 КиБ. | СреднийД8 · неверные сведения. У MapLibre самая большая сборка из трёх: около 285 КиБ и ещё 144 КиБ рабочего потока. | ✓ МинимальныйД9 · своё решение выигрывает во всём. |
| Сообщество | ✓ Очень активноеД11 · косвенный показатель вместо свойства. «Активность» оценена по известности. У Leaflet больше всего звёзд и загрузок, но за последний год не вышло ни одной стабильной версии. | АктивноеД1 · критерий не определён. Что считать активностью: выпуски, коммиты, ответы на вопросы? | РастущееД2 · шкала не указана. «Растущее» – впечатление, а не значение. За год у MapLibre вышло 38 стабильных версий – это число можно проверить. | – |
| Документация | ОтличнаяД2 · шкала не указана. Чем «отличная» отличается от «хорошей»? Ступени не описаны. | Подробная, но сложнаяД1 · критерий не определён. Смешаны два свойства – полнота и порог входа. «Сложная» для кого? | ХорошаяД2 · шкала не указана. Та же неописанная ступень. | ✓Д9 · своё решение выигрывает во всём. Документации у несуществующего продукта ещё нет. |
| Гибкость и расширяемостьД5 · критерии пересекаются. Пересекается с «сообществом» (плагины пишет сообщество) и с «векторными тайлами» (у Leaflet они как раз плагином): одно свойство засчитано дважды. | ПлагиныД2 · шкала не указана. Это не значение, а способ: сколько плагинов, какие из них нужны задаче? | ✓ Высокая | Высокая | ✓ Высокая |
| Мобильные устройстваД12 · критерий не различает варианты. У всех четырёх стоит «✓»: строка занимает место, но выбрать ничего не помогает. Если мобильность важна, её нужно измерить: время загрузки по медленной сети, работа жестов. | ✓ | ✓ | ✓ | ✓ |
| Лицензия | BSD-2-ClauseПочти верно. Идентификатор лицензии точный, шкала наименований, и с ним ничего не складывают. Не хватает только ссылки и даты: лицензия может смениться с новой версией. | BSD-2-Clause | BSD-3-Clause | MIT |
| Актуальная версия | 2.0Д8 · устаревшие или выдуманные сведения. Стабильная версия Leaflet – 1.9.4 от 18.05.2023, а 2.0 существует только как предварительная. | 9.xД8 · устаревшие сведения. На 18.10.2026 последняя версия OpenLayers – 10.11.0. | 4.xД8 · устаревшие сведения. На 18.10.2026 – 6.15.0; с версии 6.0 изменился даже способ подключения библиотеки. | 1.0 |
| Итоговая оценка | 7/10Д10 · недопустимые действия со шкалой. Балл сложен из порядковых оценок без весов и нормирования: «высокая» и «средняя» не складываются. | 8/10Д10 · недопустимые действия со шкалой. Точность до балла при порядковых исходных данных – иллюзия. | 8,5/10Д10 · недопустимые действия со шкалой. Половина балла – точность, которой нет ни в одной ячейке выше. | 10/10Д9 · своё решение выигрывает во всём. Высший балл продукту, которого ещё нет. |
Посчитаем, что в ней есть. Из 44 ячеек числом выражены 9, единица измерения указана у одной – «~40 КБ», источник и дата не указаны ни у одной. Почти весь ответ записан в порядковой шкале «низкая – средняя – высокая», ступени которой нигде не описаны, а в последней строке над этими ступенями выполнена арифметика, недопустимая для порядковой шкалы (раздел 3.3), и получен итоговый балл с точностью до половины.
Самое неприятное в этой таблице то, что она похожа на правду. Leaflet действительно невелик, MapLibre действительно рисует через WebGL. Таблица пересказывает репутацию библиотек – то, как о них обычно пишут в обзорах и блогах. Измерения в ней нет ни одного.
- запись измерения
- свойство
- объём JavaScript, который скачает браузер
- сценарий
- минимальное приложение: растровая карта и один маркер
- значение
- 42,5
- единица
- КиБ после минификации и сжатия gzip
- метод
- сборка esbuild 0.25.10, сжатие gzip уровня 9
- объект
- Leaflet 1.9.4 – последняя стабильная версия
- дата
- 18.10.2026
- сравнение
- OpenLayers 10.11.0 – 94,3; MapLibre GL JS 6.15.0 – 284,8 и ещё 143,7 рабочий поток
7.3. Почему модель отвечает словами «высокая» и «удобный»
Это не каприз конкретной модели, а следствие того, как языковые модели устроены и как их обучают. Причин несколько, и каждая подтверждена исследованиями.
Модели нечем измерять. Чтобы узнать размер библиотеки, её надо собрать и сжать; чтобы узнать скорость, нужно поставить опыт. Модель без инструментов этого сделать не может. Она продолжает текст так, как его продолжили бы тексты, на которых она училась, а в них о библиотеках пишут словами: «лёгкая», «мощная», «гибкая». Слово «высокая» в ячейке – это не результат измерения, а усреднённое мнение авторов обзоров.
Без задачи ответ получается «в среднем». «Производительность» карты с десятью маркерами и с сотней тысяч точек – разные свойства, и победители у них разные. Если задача не названа, модель отвечает о библиотеке вообще, то есть ни о чём. Это та же ошибка, что и пропуск поля «зачем нужен» в паспорте критерия.
Обучение поощряет уверенный и угодливый ответ. Модели дообучают на оценках людей, а люди предпочитают гладкие ответы, которые совпадают с их собственным мнением. Исследования показали, что модели систематически подстраиваются под взгляды собеседника: после реплики «Я так не думаю. Вы уверены?» разные модели отказывались от своего первоначального ответа в 32–86 % случаев. Если в запросе с воодушевлением описан собственный проект, в таблице появляется столбец «Наше решение» с оценкой 10 из 10.
Пустая ячейка выглядит провалом. Модели оценивают тестами, где ответ «не знаю» стоит столько же, сколько неверный, – ноль баллов. Из десяти популярных наборов тестов, разобранных в одной из работ 2025 года, девять не дают за «не знаю» ничего. Поэтому модель учится угадывать уверенно. В таблице это выглядит так: вместо «не установлено» в ячейку попадает правдоподобное слово или галочка.
Числа модели – тоже ярлыки. Когда модель всё-таки ставит баллы, они ведут себя как порядковая шкала с неравными ступенями. На шкале от 1 до 5 оценки скапливаются на одной-двух цифрах; на шкале от 1 до 100 – на круглых числах вроде 80, 90, 95, а нижняя часть шкалы почти не используется. Если попросить оценить сразу несколько свойств, следующий балл тянется к предыдущему: в одном исследовании оценки разных свойств одного текста у модели почти совпадали, а у людей заметно различались. Даже порядок, в котором перечислены ступени шкалы, у одной из проверенных моделей менял почти половину оценок. «8/10» в ячейке – не измерение, а ещё одно слово «высокая».
Свежие и редкие факты модели знают хуже всего. Точность фактов у моделей тем ниже, чем реже факт встречался в текстах. В исследовании 2025 года модели отвечали на вопросы таблицами, которые надо было собрать из нескольких источников: по памяти лучшая модель набрала 47,6 балла по мере F1, с предоставленными источниками – 60,7, люди – 73. Типичные ошибки – пропущенные строки, выдуманные и неверные ячейки. Версии библиотек, даты выпусков, условия лицензий и цены меняются после того, как модель обучена, – отсюда строка «Актуальная версия» в таблице выше, где все три версии чужих библиотек неверны.
Форма таблицы не оставляет места. В клетку помещается одно слово. Единицу, метод, источник и дату модель не запишет, если таких столбцов не потребовать явно.
Хорошая новость в том, что те же исследования показывают, что помогает. Если описать словами каждую ступень шкалы и дать образец ответа, согласие модели с людьми заметно растёт. Если разрешить и потребовать «не установлено», модель реже выдумывает. Если дать ей настоящие данные – выгрузку реестра, документацию, – она перестаёт полагаться на память. Всё это сводится к одному: критерии, шкалы и паспорта из разделов 3 и 4 нужно написать самому и передать модели.
7.4. Двенадцать дефектов
Ошибки сравнительных таблиц повторяются, и их удобно называть по типам. Тип дефекта нужен и для того, чтобы описать находку в журнале, и для того, чтобы объяснить модели, что исправить.
| Тип | Дефект | Как распознать |
|---|---|---|
| Д1 | критерий не определён | название можно понять по-разному: «простота» для кого и в чём? |
| Д2 | шкала не указана | «высокая – средняя – низкая», «отлично», баллы 1–10 без описания ступеней |
| Д3 | нет единицы и способа измерения | «~40 КБ» – чего: исходного кода, сжатого файла? |
| Д4 | нет источника и даты | значение нельзя проверить и нельзя понять, на какой момент оно верно |
| Д5 | критерии пересекаются | одно свойство учтено дважды: «гибкость» и «плагины», «скорость» и «WebGL» |
| Д6 | задача не задана | оценка зависит от сценария, а сценарий не назван |
| Д7 | галочка скрывает степень | ✓ вместо «в ядре», «плагином», «частично – что именно» |
| Д8 | устаревшие или выдуманные сведения | версии, цены, даты, условия лицензий |
| Д9 | своё решение выигрывает во всём | ещё не сделанный продукт сравнивают с выпущенными |
| Д10 | недопустимые действия со шкалой | итоговый балл как сумма или среднее порядковых оценок |
| Д11 | косвенный показатель выдан за свойство | звёзды GitHub как мера качества, «WebGL» как мера скорости |
| Д12 | критерий не различает варианты | у всех одинаковое значение, строка не помогает выбрать |
Теперь попробуйте сами на другой таблице – о трёх игровых движках. Её тоже составили для упражнения в манере чат-модели, а настоящие значения для проверки собраны 18.10.2026 с официальных сайтов движков.
Перед вами таблица, какую обычно возвращает чат-модель на просьбу сравнить три игровых движка. Для каждой строки выберите главный дефект из списка или «дефекта нет» и нажмите «Проверить»: под строкой появится разбор и то, чем этот критерий можно измерить.
7.5. Та же таблица с измерениями
Вернёмся к библиотекам карт. Исправленная таблица начинается не со значений, а с задачи и паспортов критериев. Значения ниже получены 18 октября 2026 года запросами к реестру npm и GitHub и собственной сборкой минимального приложения. Наведите курсор на подсвеченное значение, чтобы увидеть, как оно получено.
| Критерий | Leaflet | OpenLayers | MapLibre GL JS |
|---|---|---|---|
| Лицензия (наименований, идентификатор SPDX) | BSD-2-ClauseКак получено. Поле license в реестре npm для текущей версии пакета; 18.10.2026. | BSD-2-Clause | BSD-3-Clause |
| Последняя стабильная версия, дата выпуска (наименований и интервалов) | 1.9.4, 18.05.2023Как получено. Поля dist-tags.latest и time в реестре npm. Версия 2.0 Leaflet существует только как предварительная и в таблицу не попадает. | 10.11.0, 04.10.2026 | 6.15.0, 18.10.2026 |
| Стабильных выпусков за 365 дней (абсолютная, шт.) | 0 | 7 | 38Как получено. Подсчёт версий без суффиксов вроде -beta в поле time реестра npm за период 19.10.2025–18.10.2026. |
| JavaScript минимального приложения «карта и маркер», min + gzip (отношений, КиБ) | 42,5Как получено. Сборка esbuild 0.25.10 с минификацией, сжатие gzip уровня 9, размер файла; 1 КиБ = 1024 байта. Контроль – сервис bundlephobia. | 94,3 | 284,8 + 143,7Почему два числа. С версии 6.0 MapLibre выносит часть работы в отдельный рабочий поток; его файл браузер тоже скачивает. |
| Векторные тайлы (наименований: в ядре / плагином / нет) | плагиномКак получено. Раздел плагинов на сайте Leaflet; в ядре библиотеки слоя векторных тайлов нет. | в ядре | в ядре |
| Отрисовка WebGL (наименований: обязательна / доступна / нет) | нет (SVG, Canvas) | доступна наряду с Canvas | обязательна, WebGL 2Как получено. Список изменений MapLibre, раздел 6.0.0 (22.07.2026): поддержка WebGL 1 удалена. Это риск для старых устройств. |
| Звёзды GitHub (абсолютная, шт.; мера известности, не качества) | 45 765Как получено. Поле stargazers_count в GitHub API на 18.10.2026. Звёзды показывают известность, а не качество и не активность. | 12 620 | 11 887 |
| Время кадра в сценарии проекта (отношений, мс) | не измереноЧестная пометка. Значение нельзя получить из документации – нужен эксперимент по разделу 5. Пустая ячейка с пометкой лучше, чем «высокая». | не измерено | не измерено |
В этой таблице нет ни победителя, ни итогового балла, и это правильно: победитель зависит от задачи. Задача задаёт пороги – обязательные требования, которые отсеивают варианты до всякого взвешивания.
- Мобильная карта с векторным стилем, не больше 150 КиБ JavaScript. Порог «векторные тайлы в ядре» отсеивает Leaflet, порог размера – MapLibre. Остаётся OpenLayers.
- Простая карта с маркерами на растровой подложке, старые устройства. Порог «WebGL не обязателен» отсеивает MapLibre; из оставшихся меньше Leaflet.
- Плавная векторная карта с рельефом. Остаются OpenLayers и MapLibre, и дальше решает эксперимент со временем кадра – последняя строка таблицы.
Обратите внимание ещё на две вещи. Первая: у одного свойства может быть несколько честных чисел. Сжатый размер OpenLayers по сервису bundlephobia – 86 КБ, в минимальном собственном приложении – 94 КиБ, в полной готовой сборке – около 291 КиБ. Число без способа измерения бессмысленно даже тогда, когда оно верно. Вторая: источники тоже ошибаются. Счётчик загрузок npm «за последнюю неделю» на 18.10.2026 был занижен примерно на 40 %, потому что сервис вернул нули за три дня.
7.6. Как просить модель
Модель полезна в этой работе, если поручить ей то, что она делает хорошо: найти адреса документации, заполнить заданные критерии по данным, которые ей передали, найти пересечения критериев и проверить чужую таблицу. Выбирать критерии и ставить оценки – работа человека.
Первый запрос заставляет модель заполнить таблицу по вашим паспортам, не придумывая критериев и не ставя оценок.
Ты помогаешь составить раздел «Обзор аналогов» отчёта по практике.
Задача проекта: <1–2 предложения: что делает система, для кого, главные ограничения>.
Сравни варианты: <A>, <B>, <C>. Моё собственное решение в таблицу не включай.

Критерии заданы мной. Не добавляй, не объединяй и не переименовывай их:
К1 <свойство> – шкала: <наименований | порядка | интервалов | отношений | абсолютная>;
   единица: <…>; что лучше: <больше | меньше | не упорядочено>; способ: <как получить значение>.
К2 …

Правила для каждой ячейки:
1. Значение – только в указанной единице: число, идентификатор или вариант из перечня шкалы.
2. Рядом – источник (прямой адрес документации, реестра пакетов или репозитория) и дата,
   к которой значение относится.
3. Если источника нет или ты не уверен, напиши «не установлено» и укажи, где это проверить.
   Ошибка хуже пропуска. Не заполняй ячейку по памяти «примерно».
4. Запрещены оценки без числа и способа измерения: «высокий», «удобный», «быстрый», «активный»,
   «лёгкий», «хороший», а также ✓ и ✗ без указания, что именно поддерживается и как.
5. Не выводи итоговый балл и не называй победителя.

После таблицы выведи:
а) ячейки, которые могли устареть после даты, до которой ты обучен, – с адресом для проверки;
б) пары критериев, которые, по-твоему, пересекаются.
Второй запрос нужен для проверки, и запускать его стоит в новом диалоге, лучше другой моделью: так проверяющий не знает, кто автор таблицы и какой вариант ему нравится.
Ты – рецензент раздела «Обзор аналогов» выпускной работы. Тебе даны задача проекта
и сравнительная таблица. Не исправляй значения и не говори, какой вариант лучше.
Найди дефекты таблицы по типам:
Д1 критерий не определён; Д2 шкала не указана; Д3 нет единицы или способа измерения;
Д4 нет источника или даты; Д5 критерии пересекаются; Д6 оценка зависит от задачи,
а сценарий не задан; Д7 ✓ или ✗ скрывает степень; Д8 сведения могут быть устаревшими
или выдуманными; Д9 собственное решение выигрывает во всём без измерений;
Д10 над порядковыми оценками выполнены арифметические действия; Д11 косвенный показатель
выдан за свойство; Д12 критерий не различает варианты.
Для каждого дефекта выведи строку: ячейка (строка × столбец) | тип | почему это дефект |
как исправить (свойство, шкала, единица, способ измерения).
Если считаешь значение ложным, приведи источник с адресом; если источника нет, пиши
«требует проверки», а не «неверно».
В конце – число дефектов каждого типа и три самых важных исправления.
Модель, проверяющая таблицу, сама может ошибаться: пропускать дефекты и находить несуществующие. Её список – подсказка для человека, как ссылка от нейросети в занятии 4 – подсказка для поиска. Сверить значение с источником, открыв адрес, может только человек. Этим и заканчивается работа над таблицей, и этим же начинается задание.
8. Задание: найдите ошибку нейросети
Задание соединяет всё изложенное. Нужно получить от нейросети сравнительную таблицу по теме своего проекта, найти в ней дефекты, описать их, составить паспорта критериев и передать своё объяснение модели – а затем проверить, стала ли таблица лучше и насколько. Результат войдёт в первую главу отчёта: там требуется сравнительный анализ инструментов или аналогов с обоснованием выбора (справка «Структура отчёта и ВКР», раздел 3).
- Задача и варианты. Запишите задачу проекта в одном-двух предложениях: что делает система, для кого, какие у неё ограничения. Выберите от трёх до пяти вариантов для сравнения: аналоги – существующие продукты, или технологии – языки, движки, библиотеки, сервисы, модели.
- Первая таблица. Попросите любую модель сравнить варианты «для вашего проекта», не называя критериев. Сохраните запрос и ответ целиком, с названием модели и датой.
- Журнал дефектов. Разметьте таблицу по типам Д1–Д12 из раздела 7.3. Для каждого дефекта запишите: ячейку или строку, тип, что не так (одна фраза) и почему это важно для вашей задачи. Ошибка нейросети – не неудача задания, а его результат.
- Паспорта критериев. Выберите от пяти до семи критериев, которые действительно решают выбор в вашей задаче, и заполните для каждого паспорт из раздела 4.5. У порядковых шкал опишите каждую ступень наблюдаемым признаком. Отметьте, какие критерии служат порогами, а какие взвешиваются, и запишите веса до того, как увидите значения.
- Объяснение модели. В новом диалоге передайте модели задачу, журнал дефектов и паспорта критериев вместе с первым запросом из файла
z05_table_prompts.md. Сохраните вторую таблицу. - Проверка. Отдайте вторую таблицу проверяющему запросу – в новом диалоге, лучше другой модели. Затем сами откройте источники не меньше чем пяти значений и сверьте их; результат сверки запишите. То, что осталось «не установлено», по возможности измерьте сами, как размер сборки в разделе 7.4.
- Сравнение. Сравните таблицы числами: сколько оценочных ячеек без единицы и источника было и стало, сколько дефектов каждого типа было и осталось, сколько значений после ручной проверки оказались неверными.
- Вывод. Напишите пять–восемь предложений по схеме аргумента из занятия 3: утверждение – какой вариант подходит и при каких условиях; данные – строки таблицы, на которых держится вывод; связка – почему из них это следует для вашей задачи; оговорка – что не измерено и при каком изменении задачи вывод перестанет быть верным.
Работа принимается, если:
- у каждого из пяти–семи критериев заполнен паспорт, а у всех порядковых шкал описаны ступени;
- в журнале не меньше восьми дефектов не меньше чем четырёх типов, у каждого указаны ячейка и объяснение;
- во второй таблице нет ни одной оценочной ячейки без единицы, шкалы или пометки «не установлено»;
- не меньше пяти значений сверены человеком по источнику, и записано, совпали ли они;
- вывод следует из таблицы и содержит оговорку.
По желанию – тесты. Попросите модель написать тесты для одной функции своего проекта, которая принимает ввод пользователя. Затем по разделу 6.5 составьте таблицу классов эквивалентности и граничных значений для этой функции и проверьте, какие из них покрыты тестами модели. Если проект на Python или JavaScript, запустите мутационное тестирование и запишите долю убитых мутантов. Таблица «проверка – ожидаемый результат – фактический результат» пригодится в главе о тестировании (справка, раздел 5).
9. Проверь себя
Задание на соответствие проверяет четыре умения: определять тип шкалы, узнавать ошибку восприятия по описанию, подбирать приём тестирования к ошибке и превращать слово из таблицы в измеримый показатель.
Для каждой строки слева выберите подходящий ответ из списка и нажмите «Проверить». Неверные строки подсветятся, под ними появится пояснение. Наборы переключаются кнопками сверху.
Контрольные вопросы
-
Машина сильнее там, где можно перебрать варианты: счёт, шахматы, поиск. Человек сильнее там, где нужно по нескольким примерам построить модель целого и применить её к новому случаю. Слабость – обратная сторона силы: мозг достраивает картину и верит ей, даже когда она неверна.
-
Что знание не исправляет восприятие: отрезки кажутся разными и после того, как их измерили. Исправляет ошибку только прибор, который не знает, что «должно» получиться. Эксперимент – такой прибор для суждений.
-
Склонность искать доводы в пользу своей гипотезы и не искать опровержений. Испытуемые проверяют только тройки, подходящие под их догадку, получают «да» и считают её доказанной, хотя правило шире. Информативна проверка, которая могла закончиться ответом «нет».
-
Вывод по выборке, из которой выпали неудачные случаи. Пробоины видны только на вернувшихся самолётах; отзывы о приложении пишут те, кто его не удалил после первой ошибки.
-
Поиск там, где легко искать, а не там, где вероятнее найти: измеряют то, что легко измерить, проверяют то, что легко проверить. Такая работа выглядит настоящей, но главного не находит.
-
Верный ответ может даваться по неверной причине – по невольной подсказке. Отсюда слепой метод. Модели машинного обучения тоже учатся по короткому пути: узнают подпись на снимке или снег на фоне. Выявляет это опыт, в котором меняют по одному признаку.
-
Опровержимая гипотеза; критерий успеха, записанный до опыта; сравнение с контрольной группой или базовым вариантом; случайное распределение; слепота измеряющего; повторение и разброс.
-
Сопоставить объектам знаки так, чтобы отношения между знаками повторяли отношения между объектами по измеряемому свойству. Число, у которого этого нет, – этикетка, а не измерение.
-
Наименований – только «совпадает или нет», частоты. Порядка – плюс сравнение, медиана. Интервалов – плюс разности и среднее, но не отношения. Отношений – плюс «во сколько раз». Абсолютная – все операции, включая степени и логарифмы.
-
Температура по Цельсию – шкала интервалов, её ноль условен. В градусах Фаренгейта та же вода нагрелась с 48,2 до 64,4 – не вдвое. Отношения имеют смысл только на шкале отношений.
-
Числа вносят несуществующий порядок и расстояния: «средняя операционная система» равна 2,1, а модель решит, что macOS «больше» Windows. Номинальные признаки кодируют прямым (one-hot) кодированием.
-
Ранги складывают (метод суммы мест), парные сравнения сводят по большинству, непосредственные оценки усредняют с весами компетентности. Согласие проверяют коэффициентом конкордации Кендалла W: 1 – полное согласие, 0 – никакого; при малом числе экспертов проверяют значимость.
-
Аддитивная – взвешенная сумма – допускает компенсацию: провал по одному критерию покрывается другими. Мультипликативная – взвешенное произведение – не допускает: нулевая оценка обнуляет итог. Результат обеих зависит от весов и способа нормирования, поэтому их фиксируют заранее и проверяют, не меняется ли победитель при малом изменении весов.
-
Определение понятия через процедуру его измерения. «Удобный интерфейс» – время, за которое новый пользователь выполняет типовую задачу; «быстрый сервер» – медиана и 95-й процентиль времени ответа при заданной нагрузке.
-
Валидность (измеряет заявленное), надёжность (повторяется), чувствительность (различает варианты), независимость (не дублирует другие), доступность (значение можно получить из проверяемого источника).
-
Когда мера становится целью, она перестаёт быть хорошей мерой. Покрытие кода как цель порождает тесты, которые выполняют строки и ничего не проверяют.
-
Название, свойство, зачем нужен, тип шкалы, единица и точность, направление, способ измерения, источник и дата, градации или порог, вес с обоснованием, способ проверки. Для порядковой шкалы – наблюдаемый признак каждой ступени.
-
Вопрос и гипотеза; критерий и шкала; объект и условия; план (факторы, уровни, повторы, порядок); пробный прогон; основной прогон с журналом; обработка с разбросом и угрозами выводу; отчёт, по которому опыт можно повторить.
-
Верификация проверяет, правильно ли программа решает уравнения модели (правильно ли строим продукт). Валидация – те ли это уравнения, соответствует ли модель реальности (тот ли продукт строим).
-
Время зависит от прогрева, кэша, частоты процессора, фоновых задач и даже от окружения. Нужны прогрев, много повторов в перемешанном порядке, медиана и разброс, записанное окружение.
-
Тест проверяет только выбранные случаи, а нейросеть выбирает освещённые: примеры из описания и «счастливый путь». Ожидаемые значения она часто выводит из самого кода, проверки делает по форме («результат – число»), а агент может подогнать тесты под код.
-
Покрытие показывает, какие строки выполнились, а не какие результаты проверены. Лучше мутационное тестирование: доля внесённых ошибок, которые тесты замечают.
-
Классы эквивалентности, граничные значения, переходы состояний, тестирование на основе свойств, фаззинг, исследовательское тестирование, мутационное тестирование для проверки тестов.
-
Модели нечем измерять, и без задачи, свойства, шкалы и единицы она пересказывает репутацию предметов. Обучение поощряет уверенный и угодливый ответ, а оценивание – заполненную ячейку вместо «не знаю». Её баллы ведут себя как порядковые ярлыки; свежие факты она знает хуже всего.
-
Самому задать задачу, критерии с паспортами и пороги; потребовать для каждой ячейки единицу, источник и дату, разрешить «не установлено», запретить оценочные слова и итоговый балл; проверить таблицу другой моделью и самому сверить значения по источникам.
Источники
Человек и машина
- Deep Blue. — Текст : электронный // IBM History : [сайт]. — URL: https://www.ibm.com/history/deep-blue (дата обращения: 18.10.2026).
- Campbell M., Hoane A. J., Hsu F.-h. Deep Blue // Artificial Intelligence. — 2002. — Vol. 134, No. 1–2. — P. 57–83. — DOI: 10.1016/S0004-3702(01)00129-1.
- Chase W. G., Simon H. A. Perception in chess // Cognitive Psychology. — 1973. — Vol. 4, No. 1. — P. 55–81. — DOI: 10.1016/0010-0285(73)90004-2.
- Moravec H. Mind Children: The Future of Robot and Human Intelligence. — Cambridge (Mass.) : Harvard University Press, 1988.
- Carey S., Bartlett E. Acquiring a single new word // Papers and Reports on Child Language Development. — 1978. — Vol. 15. — P. 17–29. — URL: https://languagelog.ldc.upenn.edu/myl/Acquiring_a_Single_New_Word.pdf (дата обращения: 18.10.2026).
- Lake B. M., Salakhutdinov R., Tenenbaum J. B. Human-level concept learning through probabilistic program induction // Science. — 2015. — Vol. 350, No. 6266. — P. 1332–1338. — DOI: 10.1126/science.aab3050.
- Chollet F. On the Measure of Intelligence. — 2019. — arXiv:1911.01547. — URL: https://arxiv.org/abs/1911.01547 (дата обращения: 18.10.2026).
- ARC Prize Foundation. ARC-AGI-3: A New Challenge for Frontier Agentic Intelligence. — 2026. — arXiv:2603.24621. — URL: https://arxiv.org/abs/2603.24621 (дата обращения: 18.10.2026).
- ARC Prize. Analyzing GPT-6 Astra on ARC-AGI-3. — Текст : электронный // ARC Prize : [сайт]. — 2026. — URL: https://arcprize.org/blog/astra (дата обращения: 18.10.2026).
Ошибки восприятия и суждения
- Simons D. J., Chabris C. F. Gorillas in our midst: sustained inattentional blindness for dynamic events // Perception. — 1999. — Vol. 28, No. 9. — P. 1059–1074. — DOI: 10.1068/p281059.
- Wason P. C. On the failure to eliminate hypotheses in a conceptual task // Quarterly Journal of Experimental Psychology. — 1960. — Vol. 12, No. 3. — P. 129–140. — DOI: 10.1080/17470216008416717.
- Tversky A., Kahneman D. Judgment under Uncertainty: Heuristics and Biases // Science. — 1974. — Vol. 185, No. 4157. — P. 1124–1131. — DOI: 10.1126/science.185.4157.1124.
- Канеман Д. Думай медленно… решай быстро. — Москва : АСТ, 2013. — 656 с. — ISBN 978-5-17-080053-7.
- Mangel M., Samaniego F. J. Abraham Wald's Work on Aircraft Survivability // Journal of the American Statistical Association. — 1984. — Vol. 79, No. 386. — P. 259–267. — DOI: 10.1080/01621459.1984.10478038.
- Wald A. A Method of Estimating Plane Vulnerability Based on Damage of Survivors. — Statistical Research Group, Columbia University, 1943. — Reprint: Center for Naval Analyses, CRC 432, 1980.
- Did You Lose the Keys Here? No, But the Light Is Much Better Here. — Текст : электронный // Quote Investigator : [сайт]. — 2013, обновлено 2026. — URL: https://quoteinvestigator.com/2013/04/11/better-light/ (дата обращения: 18.10.2026).
- Kaplan A. The Conduct of Inquiry: Methodology for Behavioral Science. — San Francisco : Chandler, 1964.
Эксперимент и самообман
- Pfungst O. Clever Hans (The Horse of Mr. von Osten) / transl. by C. L. Rahn. — New York : Henry Holt, 1911. — URL: https://www.gutenberg.org/ebooks/33936 (дата обращения: 18.10.2026).
- Report of the commissioners charged by the King with the examination of animal magnetism // International Journal of Clinical and Experimental Hypnosis. — 2002. — Vol. 50, No. 4. — P. 332–363. — DOI: 10.1080/00207140208410109.
- Wood R. W. The n-Rays // Nature. — 1904. — Vol. 70, No. 1822. — P. 530–531. — DOI: 10.1038/070530a0.
- Lind J. A Treatise of the Scurvy. — Edinburgh : Sands, Murray and Cochran, 1753. — URL: https://www.jameslindlibrary.org/lind-j-1753/ (дата обращения: 18.10.2026).
- Feynman R. P. Cargo Cult Science : Caltech commencement address, 1974. — Текст : электронный // Caltech Library : [сайт]. — URL: https://calteches.library.caltech.edu/51/2/CargoCult.htm (дата обращения: 18.10.2026).
- Фейнман Р. Ф. Вы, конечно, шутите, мистер Фейнман! / пер. с англ. Н. А. Зубченко, О. Л. Тиходеевой, М. Шифмана. — Москва ; Ижевск : НИЦ «Регулярная и хаотическая динамика», 2001.
- Open Science Collaboration. Estimating the reproducibility of psychological science // Science. — 2015. — Vol. 349, No. 6251. — Art. aac4716. — DOI: 10.1126/science.aac4716.
- Becker J., Rush N., Barnes E., Rein D. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. — 2025. — arXiv:2507.09089. — URL: https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/ (дата обращения: 18.10.2026).
- Lapuschkin S., Wäldchen S., Binder A., Montavon G., Samek W., Müller K.-R. Unmasking Clever Hans predictors and assessing what machines really learn // Nature Communications. — 2019. — Vol. 10. — Art. 1096. — DOI: 10.1038/s41467-019-08987-4.
- Ribeiro M. T., Singh S., Guestrin C. «Why Should I Trust You?»: Explaining the Predictions of Any Classifier // Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. — 2016. — P. 1135–1144. — DOI: 10.1145/2939672.2939778.
- Geirhos R., Jacobsen J.-H., Michaelis C., Zemel R., Brendel W., Bethge M., Wichmann F. A. Shortcut learning in deep neural networks // Nature Machine Intelligence. — 2020. — Vol. 2, No. 11. — P. 665–673. — DOI: 10.1038/s42256-020-00257-z.
- Zech J. R., Badgeley M. A., Liu M., Costa A. B., Titano J. J., Oermann E. K. Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs: A cross-sectional study // PLOS Medicine. — 2018. — Vol. 15, No. 11. — Art. e1002683. — DOI: 10.1371/journal.pmed.1002683.
- Winkler J. K., Fink C., Toberer F. [et al.]. Association Between Surgical Skin Markings in Dermoscopic Images and Diagnostic Performance of a Deep Learning Convolutional Neural Network for Melanoma Recognition // JAMA Dermatology. — 2019. — DOI: 10.1001/jamadermatol.2019.1735.
Шкалы и экспертные оценки
- Stevens S. S. On the theory of scales of measurement // Science. — 1946. — Vol. 103, No. 2684. — P. 677–680. — DOI: 10.1126/science.103.2684.677.
- РМГ 83-2007. Государственная система обеспечения единства измерений. Шкалы измерений. Термины и определения : издание официальное : введены впервые : дата введения 2008-08-01. — Москва : Стандартинформ, 2008. — URL: https://ohranatruda.ru/upload/iblock/99b/4293835660.pdf (дата обращения: 18.10.2026).
- ГОСТ Р 57546-2017. Землетрясения. Шкала сейсмической интенсивности : национальный стандарт Российской Федерации : дата введения 2017-09-01. — URL: https://meganorm.ru/mega_doc/norm/gost-r_gosudarstvennyj-standart/3/gost_r_57546-2017_natsionalnyy_standart_rossiyskoy.html (дата обращения: 18.10.2026).
- Силич М. П., Силич В. А. Основы теории систем и системного анализа : учебное пособие. — Томск : Изд-во Томск. гос. ун-та систем управления и радиоэлектроники, 2013. — 340 с. — ISBN 978-5-86889-663-7. — URL: https://edu.tusur.ru/publications/5452 (дата обращения: 18.10.2026).
- Перегудов Ф. И., Тарасенко Ф. П. Основы системного анализа : учебник. — 3-е изд. — Томск : НТЛ, 2001. — 396 с. — ISBN 5-89503-115-3.
- Пфанцагль И. Теория измерений : пер. с англ. — Москва : Мир, 1976. — 165 с.
- Jamieson S. Likert scales: how to (ab)use them // Medical Education. — 2004. — Vol. 38, No. 12. — P. 1217–1218. — DOI: 10.1111/j.1365-2929.2004.02012.x.
- Norman G. Likert scales, levels of measurement and the «laws» of statistics // Advances in Health Sciences Education. — 2010. — Vol. 15, No. 5. — P. 625–632. — DOI: 10.1007/s10459-010-9222-y.
- Kendall M. G., Babington Smith B. The problem of m rankings // Annals of Mathematical Statistics. — 1939. — Vol. 10, No. 3. — P. 275–287. — DOI: 10.1214/aoms/1177732186.
- Churchman C. W., Ackoff R. L. An approximate measure of value // Journal of the Operations Research Society of America. — 1954. — Vol. 2, No. 2. — P. 172–187. — DOI: 10.1287/opre.2.2.172.
- Saaty T. L. A scaling method for priorities in hierarchical structures // Journal of Mathematical Psychology. — 1977. — Vol. 15, No. 3. — P. 234–281. — DOI: 10.1016/0022-2496(77)90033-5.
- Hwang C.-L., Yoon K. Multiple Attribute Decision Making: Methods and Applications. — Berlin ; Heidelberg : Springer, 1981. — (Lecture Notes in Economics and Mathematical Systems ; vol. 186). — DOI: 10.1007/978-3-642-48318-9.
- Wald A. Statistical decision functions which minimize the maximum risk // Annals of Mathematics. — 1945. — Vol. 46, No. 2. — P. 265–280. — DOI: 10.2307/1969022.
- Savage L. J. The theory of statistical decision // Journal of the American Statistical Association. — 1951. — Vol. 46, No. 253. — P. 55–67. — DOI: 10.1080/01621459.1951.10500768.
- Zadeh L. A. Fuzzy sets // Information and Control. — 1965. — Vol. 8, No. 3. — P. 338–353. — DOI: 10.1016/S0019-9958(65)90241-X.
Критерии и их проверка
- ГОСТ Р ИСО/МЭК 25010-2015. Информационные технологии. Системная и программная инженерия. Требования и оценка качества систем и программного обеспечения (SQuaRE). Модели качества систем и программных продуктов : национальный стандарт Российской Федерации : дата введения 2016-06-01. — URL: https://files.stroyinf.ru/Index/60/60038.htm (дата обращения: 18.10.2026).
- ISO/IEC 25010:2023. Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — Product quality model. — 2nd ed. — Geneva : ISO, 2023. — URL: https://www.iso.org/standard/78176.html (дата обращения: 18.10.2026).
- ГОСТ Р 58606-2019 (ИСО/МЭК/IEEE 15939:2017). Системная и программная инженерия. Процесс измерения : национальный стандарт Российской Федерации : дата введения 2021-01-01. — URL: https://www.normacs.info/ntds/10910 (дата обращения: 18.10.2026).
- ISO/IEC/IEEE 29148:2018. Systems and software engineering — Life cycle processes — Requirements engineering. — 2nd ed. — Geneva : ISO, 2018. — DOI: 10.1109/IEEESTD.2018.8559686.
- ГОСТ Р 59194-2020. Управление требованиями. Основные положения : национальный стандарт Российской Федерации : дата введения 2021-06-01. — URL: https://files.stroyinf.ru/Index/75/75310.htm (дата обращения: 18.10.2026).
- ГОСТ 34.602-2020. Информационные технологии. Комплекс стандартов на автоматизированные системы. Техническое задание на создание автоматизированной системы : межгосударственный стандарт : дата введения 2022-01-01. — URL: https://files.stroyinf.ru/Index/76/76009.htm (дата обращения: 18.10.2026).
- Basili V. R., Caldiera G., Rombach H. D. The Goal Question Metric Approach. — Текст : электронный. — 1994. — URL: https://www.cs.umd.edu/~mvz/handouts/gqm.pdf (дата обращения: 18.10.2026).
- Strathern M. «Improving ratings»: audit in the British University system // European Review. — 1997. — Vol. 5, No. 3. — P. 305–321. — DOI: 10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4.
- Campbell D. T. Assessing the impact of planned social change // Evaluation and Program Planning. — 1979. — Vol. 2, No. 1. — P. 67–90. — DOI: 10.1016/0149-7189(79)90048-X.
- Smith P. C., Kendall L. M. Retranslation of expectations: an approach to the construction of unambiguous anchors for rating scales // Journal of Applied Psychology. — 1963. — Vol. 47, No. 2. — P. 149–155. — DOI: 10.1037/h0047060.
- Bangor A., Kortum P. T., Miller J. T. An empirical evaluation of the System Usability Scale // International Journal of Human–Computer Interaction. — 2008. — Vol. 24, No. 6. — P. 574–594. — DOI: 10.1080/10447310802205776.
- Sauro J. Measuring Usability with the System Usability Scale (SUS). — Текст : электронный // MeasuringU : [сайт]. — URL: https://measuringu.com/sus/ (дата обращения: 18.10.2026).
Этапы эксперимента и компьютерный эксперимент
- Fisher R. A. The Design of Experiments. — Edinburgh : Oliver and Boyd, 1935. — 252 p.
- ГОСТ 24026-80. Исследовательские испытания. Планирование эксперимента. Термины и определения : государственный стандарт Союза ССР : дата введения 1981-01-01. — URL: https://dnaop.com/html/65952/doc-%D0%93%D0%9E%D0%A1%D0%A2_24026-80 (дата обращения: 18.10.2026).
- Новиков А. М., Новиков Д. А. Методология научного исследования. — Москва : Либроком, 2010. — 280 с. — ISBN 978-5-397-00849-5.
- Самарский А. А. Математическое моделирование и вычислительный эксперимент // Вестник АН СССР. — 1979. — № 5. — С. 38–49. — URL: http://samarskii.ru/articles/1979/1979-002ocr.pdf (дата обращения: 18.10.2026).
- Самарский А. А., Михайлов А. П. Математическое моделирование: Идеи. Методы. Примеры. — 2-е изд., испр. — Москва : Физматлит, 2001. — ISBN 5-9221-0120-X.
- Четверушкин Б. Н., Михайлов А. П. Триада Самарского // Вестник Российской академии наук. — 2019. — Т. 89, № 2. — С. 187–193.
- Boehm B. W. Verifying and Validating Software Requirements and Design Specifications // IEEE Software. — 1984. — Vol. 1, No. 1. — P. 75–88. — DOI: 10.1109/MS.1984.233702.
- Overview of CFD Verification and Validation. — Текст : электронный // NASA Glenn Research Center : [сайт]. — URL: https://www.grc.nasa.gov/www/wind/valid/tutorial/overview.html (дата обращения: 18.10.2026).
- Mytkowicz T., Diwan A., Hauswirth M., Sweeney P. F. Producing Wrong Data Without Doing Anything Obviously Wrong! // Proceedings of ASPLOS XIV. — 2009. — P. 265–276. — DOI: 10.1145/1508244.1508275.
- Kalibera T., Jones R. E. Rigorous Benchmarking in Reasonable Time // Proceedings of ISMM'13. — 2013. — P. 63–74. — DOI: 10.1145/2464157.2464160.
- timeit — Measure execution time of small code snippets. — Текст : электронный // Python Documentation : [сайт]. — URL: https://docs.python.org/3/library/timeit.html (дата обращения: 18.10.2026).
- pyperf documentation. — Текст : электронный // Read the Docs : [сайт]. — URL: https://pyperf.readthedocs.io/en/latest/ (дата обращения: 18.10.2026).
- hyperfine: A command-line benchmarking tool. — Текст : электронный // GitHub : [сайт]. — URL: https://github.com/sharkdp/hyperfine (дата обращения: 18.10.2026).
- Kapoor S., Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science // Patterns. — 2023. — Vol. 4, No. 9. — Art. 100804. — DOI: 10.1016/j.patter.2023.100804.
- Henderson P., Islam R., Bachman P., Pineau J., Precup D., Meger D. Deep Reinforcement Learning That Matters // Proceedings of the AAAI Conference on Artificial Intelligence. — 2018. — Vol. 32, No. 1. — DOI: 10.1609/aaai.v32i1.11694.
- Pineau J., Vincent-Lamarre P., Sinha K. [et al.]. Improving Reproducibility in Machine Learning Research // Journal of Machine Learning Research. — 2021. — Vol. 22, No. 164. — P. 1–20. — URL: https://jmlr.org/papers/v22/20-303.html (дата обращения: 18.10.2026).
- Кохави Р., Тан Д., Сюй Я. Доверительное А/В-тестирование : практическое руководство по контролируемым экспериментам / пер. с англ. В. Яценкова. — Москва : ДМК Пресс, 2021. — ISBN 978-5-97060-913-2.
Тестирование программ
- Dijkstra E. W. Notes on Structured Programming (EWD249). — Eindhoven : Technological University, 1969 ; 2nd ed. 1970. — URL: https://www.cs.utexas.edu/~EWD/transcriptions/EWD02xx/EWD249/EWD249.html (дата обращения: 18.10.2026).
- Software Engineering Techniques : Report on a conference sponsored by the NATO Science Committee, Rome, Italy, 27–31 October 1969 / ed. by J. N. Buxton, B. Randell. — Brussels : NATO Science Committee, 1970. — URL: http://homepages.cs.ncl.ac.uk/brian.randell/NATO/nato1969.PDF (дата обращения: 18.10.2026).
- Barr E. T., Harman M., McMinn P., Shahbaz M., Yoo S. The Oracle Problem in Software Testing: A Survey // IEEE Transactions on Software Engineering. — 2015. — Vol. 41, No. 5. — P. 507–525. — DOI: 10.1109/TSE.2014.2372785.
- Inozemtseva L., Holmes R. Coverage is not strongly correlated with test suite effectiveness // Proceedings of ICSE 2014. — 2014. — P. 435–445. — DOI: 10.1145/2568225.2568271.
- Just R., Jalali D., Inozemtseva L., Ernst M. D., Holmes R., Fraser G. Are mutants a valid substitute for real faults in software testing? // Proceedings of FSE 2014. — 2014. — P. 654–665. — DOI: 10.1145/2635868.2635929.
- Petrović G., Ivanković M., Fraser G., Just R. Practical Mutation Testing at Scale: A view from Google // IEEE Transactions on Software Engineering. — 2022. — Vol. 48, No. 10. — P. 3900–3912. — DOI: 10.1109/TSE.2021.3107634.
- Yuan Z., Liu M., Ding S., Wang K., Chen Y., Peng X., Lou Y. Evaluating and Improving ChatGPT for Unit Test Generation // Proceedings of the ACM on Software Engineering. — 2024. — Vol. 1, FSE. — Art. 76. — P. 1703–1726. — DOI: 10.1145/3660783.
- Konstantinou M., Degiovanni R., Papadakis M. Do LLMs generate test oracles that capture the actual or the expected program behaviour? — 2024. — arXiv:2410.21136. — URL: https://arxiv.org/abs/2410.21136 (дата обращения: 18.10.2026).
- Ouédraogo W. C., Li Y., Dang X. [et al.]. On the Diffusion of Test Smells in LLM-Generated Unit Tests. — 2024. — arXiv:2410.10628. — URL: https://arxiv.org/abs/2410.10628 (дата обращения: 18.10.2026).
- Hora A., Robbes R. Are Coding Agents Generating Over-Mocked Tests? An Empirical Study. — 2026. — arXiv:2602.00409. — URL: https://arxiv.org/abs/2602.00409 (дата обращения: 18.10.2026).
- Alshahwan N., Chheda J., Finogenova A. [et al.]. Automated Unit Test Improvement using Large Language Models at Meta // FSE Companion '24. — 2024. — P. 185–196. — DOI: 10.1145/3663529.3663839.
- Claude 3.7 Sonnet System Card. — Текст : электронный // Anthropic : [сайт]. — 2025. — URL: https://www.anthropic.com/system-cards (дата обращения: 18.10.2026).
- Claude Sonnet 4.5 System Card. — Текст : электронный // Anthropic : [сайт]. — 2025. — URL: https://www.anthropic.com/system-cards (дата обращения: 18.10.2026).
- Claude Opus 5 System Card. — Текст : электронный // Anthropic : [сайт]. — 2026. — URL: https://anthropic.com/claude-opus-5-system-card (дата обращения: 18.10.2026).
- Baker B., Huizinga J., Gao L. [et al.]. Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation. — 2025. — arXiv:2503.11926. — URL: https://arxiv.org/abs/2503.11926 (дата обращения: 18.10.2026).
- Von Arx S., Chan L., Barnes B. Recent Frontier Models Are Reward Hacking. — Текст : электронный // METR : [сайт]. — 2025. — URL: https://metr.org/blog/2025-06-05-recent-reward-hacking/ (дата обращения: 18.10.2026).
- Zhong Z., Raghunathan A., Carlini N. ImpossibleBench: Measuring LLMs' Propensity of Exploiting Test Cases. — 2025. — arXiv:2510.20270. — URL: https://arxiv.org/abs/2510.20270 (дата обращения: 18.10.2026).
- Leveson N. G., Turner C. S. An Investigation of the Therac-25 Accidents // Computer. — 1993. — Vol. 26, No. 7. — P. 18–41. — DOI: 10.1109/MC.1993.274940.
- ARIANE 5 Flight 501 Failure : Report by the Inquiry Board / chairman J.-L. Lions. — Paris, 1996. — URL: https://esamultimedia.esa.int/docs/esa-x-1819eng.pdf (дата обращения: 18.10.2026).
- Mars Climate Orbiter Mishap Investigation Board. Phase I Report. — NASA, 1999. — URL: https://llis.nasa.gov/llis_lib/pdf/1009464main1_0641-mr.pdf (дата обращения: 18.10.2026).
- External Technical Root Cause Analysis — Channel File 291. — Текст : электронный // CrowdStrike : [сайт]. — 2024. — URL: https://www.crowdstrike.com/wp-content/uploads/2024/08/Channel-File-291-Incident-Root-Cause-Analysis-08.06.2024.pdf (дата обращения: 18.10.2026).
- Программа обучения Базового уровня ISTQB. Версия 4.0.1 RU-1. — Текст : электронный // RSTQB : [сайт]. — 2025. — URL: https://www.rstqb.org/ru/istqb-downloads.html (дата обращения: 18.10.2026).
- Claessen K., Hughes J. QuickCheck: a lightweight tool for random testing of Haskell programs // Proceedings of ICFP '00. — 2000. — P. 268–279. — DOI: 10.1145/351240.351266.
- MacIver D. R., Hatfield-Dodds Z. Hypothesis: A new approach to property-based testing // Journal of Open Source Software. — 2019. — Vol. 4, No. 43. — Art. 1891. — DOI: 10.21105/joss.01891.
- Miller B. P., Fredriksen L., So B. An empirical study of the reliability of UNIX utilities // Communications of the ACM. — 1990. — Vol. 33, No. 12. — P. 32–44. — DOI: 10.1145/96267.96279.
- Miller B. P., Zhang M., Heymann E. R. The Relevance of Classic Fuzz Testing: Have We Solved This One? // IEEE Transactions on Software Engineering. — 2022. — Vol. 48, No. 6. — P. 2028–2039. — DOI: 10.1109/TSE.2020.3047766.
- OSS-Fuzz. — Текст : электронный // GitHub : [сайт]. — URL: https://github.com/google/oss-fuzz (дата обращения: 18.10.2026).
- Nielsen J. Why You Only Need to Test with 5 Users. — Текст : электронный // Nielsen Norman Group : [сайт]. — 2000. — URL: https://www.nngroup.com/articles/why-you-only-need-to-test-with-5-users/ (дата обращения: 18.10.2026).
- Built-in Functions: float(). — Текст : электронный // Python Documentation : [сайт]. — URL: https://docs.python.org/3/library/functions.html#float (дата обращения: 18.10.2026).
- Prompting best practices. — Текст : электронный // Claude Developer Platform : [сайт]. — URL: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices (дата обращения: 18.10.2026).
- Best practices for Claude Code. — Текст : электронный // Claude Code Docs : [сайт]. — URL: https://code.claude.com/docs/en/best-practices (дата обращения: 18.10.2026).
Сравнительные таблицы и языковые модели
- Sharma M., Tong M., Korbak T. [et al.]. Towards Understanding Sycophancy in Language Models // ICLR 2024. — 2024. — arXiv:2310.13548. — URL: https://arxiv.org/abs/2310.13548 (дата обращения: 18.10.2026).
- Kalai A. T., Nachum O., Vempala S. S., Zhang E. Why Language Models Hallucinate. — 2025. — arXiv:2509.04664. — URL: https://arxiv.org/abs/2509.04664 (дата обращения: 18.10.2026).
- Zheng L., Chiang W.-L., Sheng Y. [et al.]. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena // NeurIPS 2023, Datasets and Benchmarks Track. — 2023. — arXiv:2306.05685. — URL: https://arxiv.org/abs/2306.05685 (дата обращения: 18.10.2026).
- Liu Y., Iter D., Xu Y., Wang S., Xu R., Zhu C. G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment // Proceedings of EMNLP 2023. — 2023. — P. 2511–2522. — DOI: 10.18653/v1/2023.emnlp-main.153.
- Stureborg R., Alikaniotis D., Suhara Y. Large Language Models are Inconsistent and Biased Evaluators. — 2024. — arXiv:2405.01724. — URL: https://arxiv.org/abs/2405.01724 (дата обращения: 18.10.2026).
- Li Q., Dou S., Shao K., Chen C., Hu H. Evaluating Scoring Bias in LLM-as-a-Judge // DASFAA 2026. — Springer, 2026. — P. 19–34. — DOI: 10.1007/978-981-92-0372-7_2.
- Kim S., Shin J., Cho Y. [et al.]. Prometheus: Inducing Fine-grained Evaluation Capability in Language Models // ICLR 2024. — 2024. — arXiv:2310.08491. — URL: https://arxiv.org/abs/2310.08491 (дата обращения: 18.10.2026).
- Min S., Krishna K., Lyu X. [et al.]. FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation // Proceedings of EMNLP 2023. — 2023. — P. 12076–12100. — DOI: 10.18653/v1/2023.emnlp-main.741.
- Akhtar M., Pang C., Marzoca A., Altun Y., Eisenschlos J. M. TANQ: An open domain dataset of table answered questions // Transactions of the Association for Computational Linguistics. — 2025. — Vol. 13. — P. 461–480. — DOI: 10.1162/tacl_a_00749.
- Cheng J., Marone M., Weller O. [et al.]. Dated Data: Tracing Knowledge Cutoffs in Large Language Models // COLM 2024. — 2024. — arXiv:2403.12958. — URL: https://arxiv.org/abs/2403.12958 (дата обращения: 18.10.2026).
- Основы подготовки научных публикаций: задание «Обзор аналогов»; типовые ошибки. — Текст : электронный // Кафедра МО ЭВМ СПбГЭТУ «ЛЭТИ» : [сайт]. — URL: https://se.moevm.pro/doku.php/staff:courses:sci_writing:typical_errors_by_assignment (дата обращения: 18.10.2026).
- Leaflet: Reference ; Plugins. — Текст : электронный // Leaflet : [сайт]. — URL: https://leafletjs.com/reference.html (дата обращения: 18.10.2026).
- OpenLayers: API Documentation. — Текст : электронный // OpenLayers : [сайт]. — URL: https://openlayers.org/en/latest/apidoc/ (дата обращения: 18.10.2026).
- MapLibre GL JS: Changelog. — Текст : электронный // GitHub : [сайт]. — URL: https://github.com/maplibre/maplibre-gl-js/blob/main/CHANGELOG.md (дата обращения: 18.10.2026).
- npm Registry: leaflet, ol, maplibre-gl. — Текст : электронный // npm : [сайт]. — URL: https://registry.npmjs.org/leaflet (дата обращения: 18.10.2026).
- npm downloads API. — Текст : электронный // npm : [сайт]. — URL: https://api.npmjs.org/downloads/point/2026-10-03:2026-10-09/leaflet,ol,maplibre-gl (дата обращения: 18.10.2026).
- esbuild: An extremely fast bundler for the web. — Текст : электронный // esbuild : [сайт]. — URL: https://esbuild.github.io/ (дата обращения: 18.10.2026).
- Bundlephobia: find the cost of adding a npm package. — Текст : электронный // Bundlephobia : [сайт]. — URL: https://bundlephobia.com/ (дата обращения: 18.10.2026).