Двумерная картограмма
- О чём эта тема
- Два относительных показателя одной заливкой: квадратная легенда 3 × 3, двумерная цветовая шкала и диаграмма рассеяния для выбора классов. Учимся строить такую карту и честно оценивать, по силам ли она читателю.
- Коротко о главном
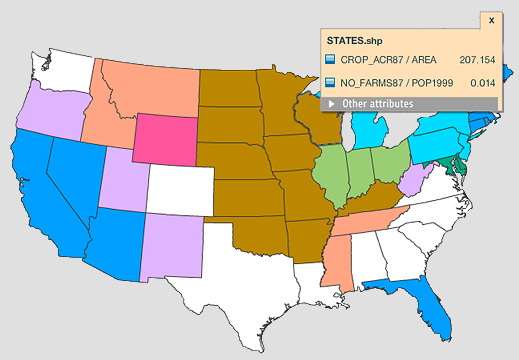
- Двумерная картограмма показывает два показателя одной заливкой: каждый показатель делят на классы, а цвет территориальной единицы определяется парой классов.
- Оба показателя должны быть относительными (или порядковыми) — как и на обычной картограмме.
- Практичный размер — 3 × 3 = 9 цветов. При 4 × 4 = 16 цветах их уже трудно надёжно различать: мешает одновременный контраст.
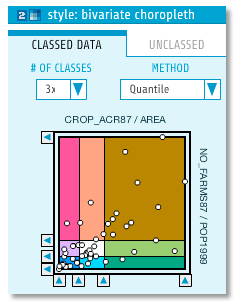
- Легенда — квадрат: по горизонтали один показатель, по вертикали другой. Для выбора границ классов смотрят на диаграмму рассеяния.
- Шкалы: последовательная × последовательная («темнее — больше») или расходящаяся × расходящаяся — только если у обоих показателей есть осмысленное среднее значение.
- Такая карта читается медленнее одномерной: чем шире аудитория, тем охотнее выбирайте простую картограмму.
- Время
- 25 минут + практика
Ключевые термины
- Картограмма, на которой цвет территориальной единицы одновременно передаёт классы двух показателей.
- Таблица цветов (например, 3 × 3), в которой светлота и цветовой тон закономерно меняются по двум осям.
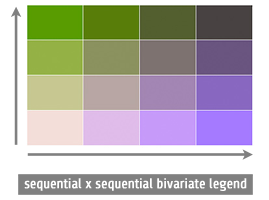
- Две однонаправленные шкалы: от светлого угла «оба мало» к тёмному «оба много». Самый частый вариант.
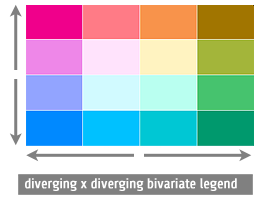
- Две двусторонние шкалы с осмысленной серединой (ноль, 50 % голосов): цвет усиливается при удалении от неё в любую сторону.
- Квантили на три класса: в каждый класс попадает по трети территориальных единиц.
- График, где каждая единица — точка с координатами (показатель 1, показатель 2). Для двумерной картограммы играет роль гистограммы.
- Восприятие цвета зависит от соседних цветов: один и тот же цвет на разном фоне кажется разным. Чем больше цветов, тем сильнее мешает.
- Осмысленное среднее значение, от которого «расходится» шкала: ноль при росте/убыли, 50 % на выборах.
Конспект
Как устроена двумерная картограмма
- Берём два относительных показателя (о том, почему абсолютные нельзя, — в конспекте «Нормирование данных»).
- Каждый делим на классы — чаще всего на 3 (терцили).
- Пара классов (класс по X, класс по Y) задаёт одну из 9 клеток.
- Цвет клетки берём из двумерной цветовой шкалы.
- Легенда — квадрат 3 × 3 со стрелками-осями и названиями показателей.
Сколько классов
| Сетка | Цветов на карте | Оценка |
|---|---|---|
| 2 × 2 | 4 | очень просто, но грубо: только «мало/много» |
| 3 × 3 | 9 | разумный компромисс — у верхнего предела для одномерной картограммы (8–9 классов) |
| 4 × 4 | 16 | цвета трудно различать, особенно на пёстрой карте; только для подготовленной аудитории |
Пример из руководства
Последовательные и расходящиеся шкалы
| Последовательная × последовательная | Расходящаяся × расходящаяся | |
|---|---|---|
| Когда | показатели просто «от меньшего к большему» | у обоих показателей есть осмысленная точка раздела |
| Как читать | светлый угол — оба мало, тёмный — оба много | центр — «около середины», углы — сильные отклонения |
| Пример | ВВП на душу × плотность населения | изменение численности населения, % (рост/убыль) × доля голосов за партию (относительно 50 %) |
Как читать двумерную картограмму
- Главная диагональ легенды (от светлого угла к тёмному): оба показателя растут вместе. Если большинство единиц окрашено её цветами — показатели связаны положительно.
- Побочная диагональ (два «чистых» цвета в углах): много одного, мало другого. Здесь обычно самое интересное — исключения из общей закономерности.
- Читатель будет возвращаться к легенде: держите её крупной и подпишите оси словами, а не «X» и «Y».
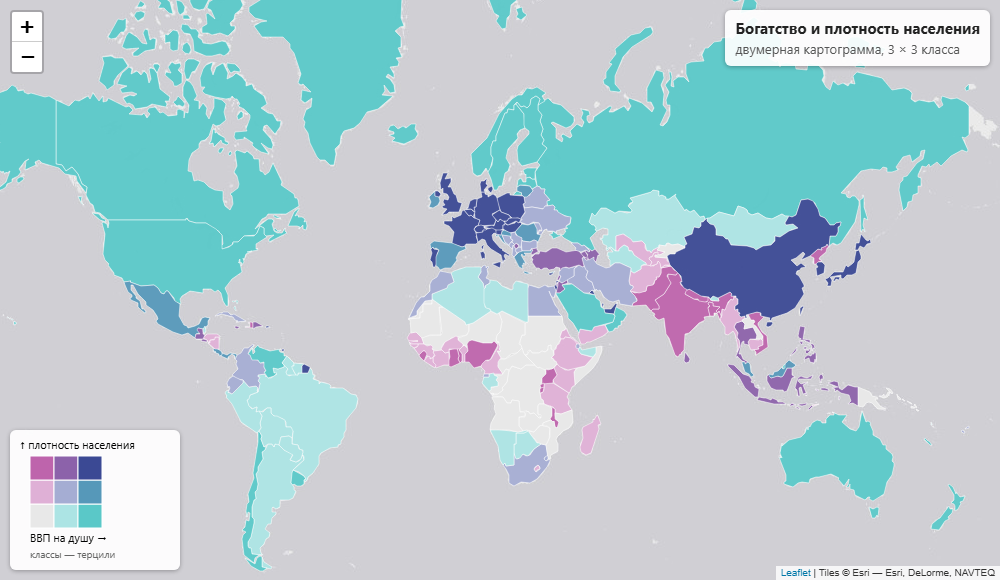
Наведите курсор на клетку легенды — на карте и на диаграмме останутся только страны этого класса. Наведите на страну или точку — подсветится её клетка. Классы — терцили; данные Natural Earth, проекция Equal Earth.
Откуда берётся двумерная шкала
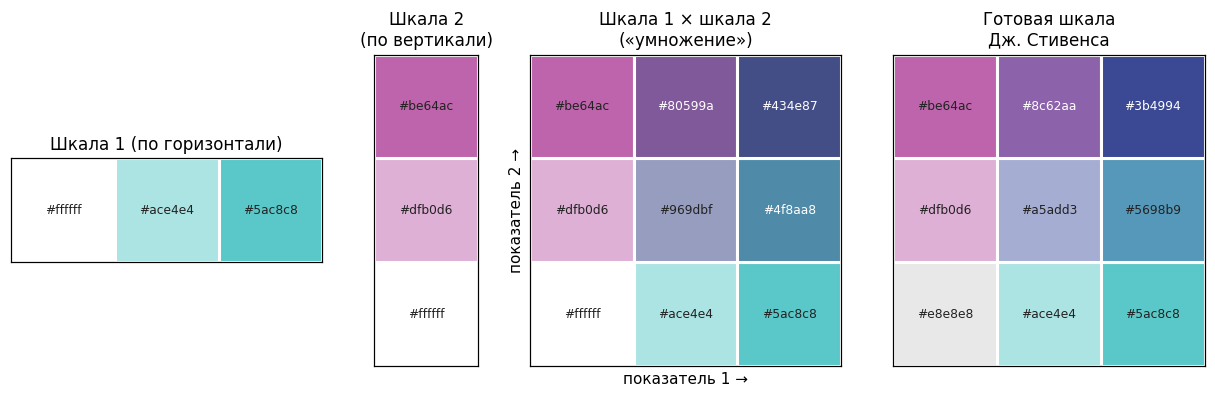
Удобный приём из статьи Джошуа Стивенса: взять две последовательные шкалы разного цветового тона и наложить их, как две прозрачные краски, — режим смешения «умножение» (multiply). Светлый угол остаётся светлым, а тёмный угол получает цвет, в котором «узнаются» обе шкалы. Затем цвета подправляют вручную, чтобы шаги светлоты были ровными. Как это сделать в Python — рецепт 3.
Делаем на Python (folium)
Данные — python/data/countries.geojson: ВВП на душу населения (gdp_per_capita) и плотность населения (pop_density), оба показателя относительные. Классы — терцили: pd.qcut(x, 3, labels=False) возвращает номера классов 0, 1, 2. Цвет — по таблице PALETTE[класс_по_Y][класс_по_X].
Рецепт 1 Терцили и диаграмма рассеяния
Перед картой — проверка классификации. pd.crosstab считает, сколько стран попало в каждую из 9 клеток; логарифмические оси нужны, потому что оба показателя сильно скошены. Обратите внимание: точки не вытянуты вдоль диагонали — богатство и плотность населения почти не связаны.
"""Классификация для двумерной картограммы: терцили и диаграмма рассеяния.

Каждый показатель делим на 3 класса по терцилям (по трети стран в классе),
получаем сетку 3 × 3 = 9 классов. Диаграмма рассеяния (как гистограмма для
одного показателя) показывает, как страны распределились по клеткам.
Шкала — «последовательная × последовательная» Джошуа Стивенса.
"""
from pathlib import Path

import geopandas as gpd
import matplotlib.pyplot as plt
import pandas as pd

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
world = world[(world["iso_a3"] != "ATA") & world["gdp_per_capita"].notna()].copy()

# PALETTE[класс по плотности][класс по ВВП]; строка 0 — нижняя (низкая плотность)
PALETTE = [["#e8e8e8", "#ace4e4", "#5ac8c8"],
           ["#dfb0d6", "#a5add3", "#5698b9"],
           ["#be64ac", "#8c62aa", "#3b4994"]]

world["cx"], gdp_bins = pd.qcut(world["gdp_per_capita"], 3, labels=False, retbins=True)
world["cy"], dens_bins = pd.qcut(world["pop_density"], 3, labels=False, retbins=True)
world["color"] = [PALETTE[cy][cx] for cx, cy in zip(world["cx"], world["cy"])]

print("Границы терцилей: ВВП на душу —", ", ".join(f"{b:,.0f}".replace(",", " ") for b in gdp_bins[1:3]),
      "долл.; плотность —", ", ".join(f"{b:.0f}" for b in dens_bins[1:3]), "чел./км²")
table = pd.crosstab(world["cy"], world["cx"]).sort_index(ascending=False)
table.index = ["плотность высокая", "средняя", "низкая"]
table.columns = ["ВВП низкий", "средний", "высокий"]
print("\nЧисло стран в каждой из 9 клеток:")
print(table.to_string())
for cy, cx, what in [(2, 2, "богатые и густонаселённые"), (0, 2, "богатые и редконаселённые"),
                     (2, 0, "бедные и густонаселённые")]:
    names = world[(world["cy"] == cy) & (world["cx"] == cx)].nlargest(4, "pop_est")["name_ru"]
    print(f"{what}: {', '.join(names)}")

fig, ax = plt.subplots(figsize=(9, 6.6))
ax.scatter(world["gdp_per_capita"], world["pop_density"], c=world["color"],
           s=46, edgecolor="#555", linewidth=0.5)
for b in gdp_bins[1:3]:
    ax.axvline(b, color="#888", linestyle="--", linewidth=1)
for b in dens_bins[1:3]:
    ax.axhline(b, color="#888", linestyle="--", linewidth=1)
LABELS = {"RUS": "Россия", "CHN": "Китай", "IND": "Индия", "USA": "США", "BGD": "Бангладеш",
          "AUS": "Австралия", "NLD": "Нидерланды", "NER": "Нигер"}
for iso, name in LABELS.items():
    row = world[world["iso_a3"] == iso].iloc[0]
    ax.annotate(name, (row["gdp_per_capita"], row["pop_density"]), xytext=(5, 4),
                textcoords="offset points", fontsize=9)
ax.set_xscale("log")  # оба показателя сильно скошены — логарифмические оси
ax.set_yscale("log")
ax.set_xlabel("ВВП на душу населения, долл. (логарифмическая шкала)")
ax.set_ylabel("Плотность населения, чел./км² (логарифмическая шкала)")
ax.set_title("Каждая точка — страна; пунктир — границы терцилей")
plt.savefig("01_scatter_tertiles.png", dpi=110, bbox_inches="tight")
Границы терцилей: ВВП на душу — 2 956, 9 923 долл.; плотность — 42, 101 чел./км²

Число стран в каждой из 9 клеток:
                   ВВП низкий  средний  высокий
плотность высокая          16       15       27
средняя                    23       24       11
низкая                     19       19       20
богатые и густонаселённые: Китайская Народная Республика, Япония, Германия, Франция
богатые и редконаселённые: США, Россия, Канада, Саудовская Аравия
бедные и густонаселённые: Индия, Пакистан, Нигерия, Бангладеш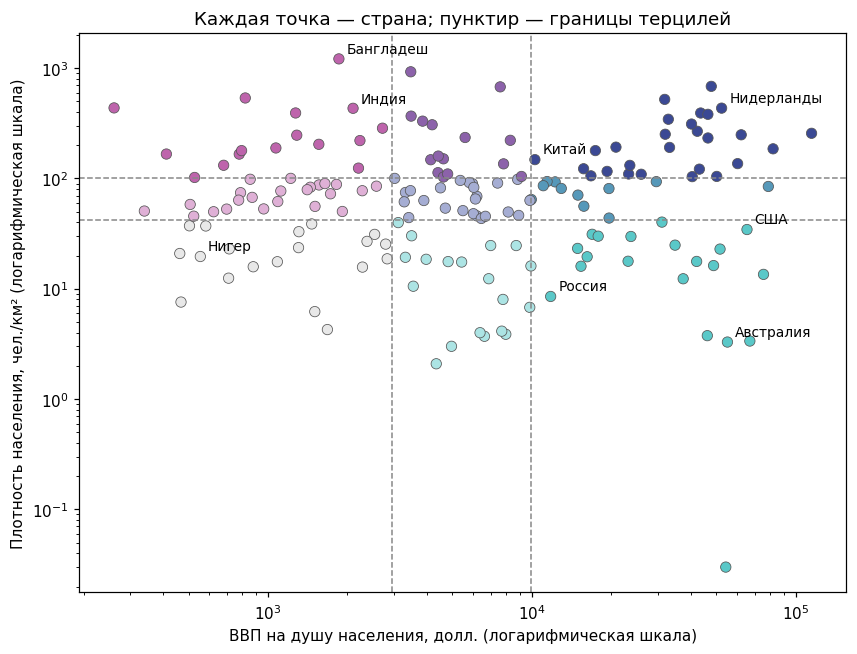
Рецепт 2 Двумерная картограмма с легендой 3 × 3
Заливка — цвет клетки, во всплывающей подсказке — оба значения и класс словами. Легенда — маленький SVG из 9 квадратов, добавленный через add_html. Бирюзовые страны (Россия, Канада, Австралия) — богатые и редконаселённые, розовые (Индия, Нигерия) — густонаселённые и небогатые, тёмно-синие (Западная Европа, Япония) — и то и другое «много».
# screenshot: 1000x580
"""Двумерная картограмма 3 × 3: ВВП на душу населения и плотность населения.

Оба показателя относительные — значит, их можно показывать заливкой.
Каждый делим на терцили, номер клетки (класс по ВВП, класс по плотности)
определяет цвет. Легенда — квадрат 3 × 3 со стрелками-осями.
"""
import sys
from pathlib import Path

import folium
import geopandas as gpd
import pandas as pd

sys.path.insert(0, str(Path(__file__).resolve().parents[1]))
from maptools import add_html, add_title, plain_attribution

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
world = world[(world["iso_a3"] != "ATA") & world["gdp_per_capita"].notna()].copy()

# Шкала Джошуа Стивенса: PALETTE[класс по плотности][класс по ВВП], строка 0 — низкая плотность
PALETTE = [["#e8e8e8", "#ace4e4", "#5ac8c8"],
           ["#dfb0d6", "#a5add3", "#5698b9"],
           ["#be64ac", "#8c62aa", "#3b4994"]]
NAMES = ["низк.", "средн.", "высок."]

world["cx"] = pd.qcut(world["gdp_per_capita"], 3, labels=False)  # терцили: 0, 1, 2
world["cy"] = pd.qcut(world["pop_density"], 3, labels=False)
world["color"] = [PALETTE[cy][cx] for cx, cy in zip(world["cx"], world["cy"])]
world["cls"] = [f"ВВП {NAMES[cx]}, плотность {NAMES[cy]}" for cx, cy in zip(world["cx"], world["cy"])]

m = folium.Map(location=[30, 15], zoom_start=2, tiles="Esri.WorldGrayCanvas")
folium.GeoJson(
    world[["name_ru", "gdp_per_capita", "pop_density", "cls", "color", "geometry"]],
    style_function=lambda f: {"fillColor": f["properties"]["color"], "color": "white",
                              "weight": 0.5, "fillOpacity": 0.95},
    tooltip=folium.GeoJsonTooltip(["name_ru", "gdp_per_capita", "pop_density", "cls"],
                                  aliases=["Страна", "ВВП на душу, долл.", "Плотность, чел./км²", "Класс"]),
).add_to(m)

# Легенда 3 × 3: по горизонтали — ВВП, по вертикали — плотность
cell = 24
svg = '<svg width="150" height="124" font-size="11"><text x="0" y="11">↑ плотность населения</text>'
for cy in range(3):
    for cx in range(3):
        svg += (f'<rect x="{10 + cx * cell}" y="{18 + (2 - cy) * cell}" width="{cell}" height="{cell}" '
                f'fill="{PALETTE[cy][cx]}" stroke="white"/>')
svg += ('<text x="10" y="104">ВВП на душу →</text>'
        '<text x="10" y="120" fill="#666" font-size="10">классы — терцили</text></svg>')
add_html(m, svg, position="bottomleft")
add_title(m, "Богатство и плотность населения", "двумерная картограмма, 3 × 3 класса")
plain_attribution(m)  # убираем флажок из подписи Leaflet
m.save("02_bivariate_map.html")
Рецепт 3 Как смешать двумерную шкалу самому
Цвет клетки = покомпонентное произведение RGB-цветов двух шкал (matplotlib.colors.to_rgb даёт числа от 0 до 1). Результат очень близок к готовой шкале Стивенса; разница в том, что в готовой шкале цвета подправлены вручную.
"""Как получить двумерную цветовую шкалу: смешиваем две последовательные шкалы.

Берём две последовательные шкалы разного цветового тона и «накладываем» их,
как две прозрачные краски при печати: цвет клетки = произведение цветов
(режим смешения «умножение», multiply). Светлый угол — оба показателя малы,
тёмный — оба велики. Сравните результат с готовой шкалой Джошуа Стивенса.
"""
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.colors import to_hex, to_rgb

RAMP_X = ["#ffffff", "#ace4e4", "#5ac8c8"]  # показатель 1 — голубой, слева направо
RAMP_Y = ["#ffffff", "#dfb0d6", "#be64ac"]  # показатель 2 — розовый, снизу вверх
STEVENS = [["#e8e8e8", "#ace4e4", "#5ac8c8"],
           ["#dfb0d6", "#a5add3", "#5698b9"],
           ["#be64ac", "#8c62aa", "#3b4994"]]

# grid[y][x] = цвет_x × цвет_y (по каждому каналу R, G, B от 0 до 1)
grid = [[to_hex(np.array(to_rgb(cx)) * np.array(to_rgb(cy))) for cx in RAMP_X] for cy in RAMP_Y]
print("Смешанная шкала (строки снизу вверх — показатель 2):")
for row in grid:
    print("  ", "  ".join(row))


def draw(ax, colors, title):
    """Рисует таблицу цветов colors[y][x], строка 0 — внизу, с подписями hex-кодов."""
    for y, row in enumerate(colors):
        for x, c in enumerate(row):
            ax.add_patch(plt.Rectangle((x, y), 1, 1, color=c, ec="white", lw=2))
            light = np.mean(to_rgb(c)) > 0.55
            ax.text(x + 0.5, y + 0.5, c, ha="center", va="center", fontsize=8,
                    color="#222" if light else "white")
    ax.set_xlim(0, len(colors[0]))
    ax.set_ylim(0, len(colors))
    ax.set_aspect("equal")
    ax.set_xticks([])
    ax.set_yticks([])
    ax.set_title(title, fontsize=11)


fig, axes = plt.subplots(1, 4, figsize=(14, 3.8), gridspec_kw={"width_ratios": [3, 1, 3, 3]})
draw(axes[0], [RAMP_X], "Шкала 1 (по горизонтали)")
draw(axes[1], [[c] for c in RAMP_Y], "Шкала 2\n(по вертикали)")
draw(axes[2], grid, "Шкала 1 × шкала 2\n(«умножение»)")
draw(axes[3], STEVENS, "Готовая шкала\nДж. Стивенса")
axes[2].set_xlabel("показатель 1 →")
axes[2].set_ylabel("показатель 2 →")
plt.savefig("03_palette_blend.png", dpi=110, bbox_inches="tight")
Смешанная шкала (строки снизу вверх — показатель 2):
   #ffffff  #ace4e4  #5ac8c8
   #dfb0d6  #969dbf  #4f8aa8
   #be64ac  #80599a  #434e87
Проверь себя
Сколько цветов на двумерной картограмме с сеткой 4 × 4?
- 4
- 8
- 16
- 24
Можно ли построить двумерную картограмму «численность населения × ВВП»?
- Да, это самый удачный выбор
- Нет: оба показателя абсолютные — сначала нормируйте (плотность, ВВП на душу)
- Да, если взять сетку 2 × 2
- Только со шкалой «расходящаяся × расходящаяся»
Когда уместна шкала «расходящаяся × расходящаяся»?
- Всегда, она нагляднее
- Когда данные классифицированы терцилями
- Когда карта будет на тёмном фоне
- Когда у обоих показателей есть осмысленная середина (например, 0 % изменения и 50 % голосов)
Страна окрашена цветом из тёмного угла легенды «последовательная × последовательная». Что это значит?
- Оба показателя у неё в верхнем классе
- Оба показателя в нижнем классе
- Данных нет
- Показатели противоположны
Зачем при построении двумерной картограммы смотрят на диаграмму рассеяния?
- Чтобы выбрать проекцию
- Чтобы подобрать цвета
- Чтобы увидеть распределение единиц по 9 клеткам и обоснованно выбрать границы классов
- Чтобы проверить, все ли страны есть в данных
Практическое задание
Постройте двумерную картограмму 3 × 3 для стран Африки или Европы по двум относительным показателям (например, ВВП на душу × плотность населения или ВВП на км² × ВВП на душу). Добавьте легенду-квадрат и диаграмму рассеяния с границами терцилей. В трёх-четырёх предложениях опишите, какие страны попали в углы легенды и есть ли связь между показателями.
- Оба показателя относительные
- Классы — терцили, построена диаграмма рассеяния с границами классов
- Двумерная шкала «последовательная × последовательная», тёмный угол — «оба много»
- В легенде 3 × 3 оси подписаны словами, со стрелками
- Во всплывающей подсказке — значения обоих показателей
Источники
- Bivariate Choropleth / Axis Maps. — Текст : электронный // Cartography Guide : [сайт]. — URL: https://www.axismaps.com/guide/bivariate-choropleth (дата обращения: 27.10.2026).
- Natural Earth : free vector and raster map data : [сайт]. — URL: https://www.naturalearthdata.com/ (дата обращения: 27.10.2026). — Текст : электронный.
- Folium : documentation : [сайт]. — URL: https://python-visualization.github.io/folium/latest/ (дата обращения: 27.10.2026). — Текст : электронный.
Конспект подготовлен по переводу руководства Cartography Guide © Axis Maps (лицензия CC BY-NC-SA 4.0) и распространяется на тех же условиях: с указанием авторства, в некоммерческих целях, с сохранением условий лицензии.