Классификация данных
- О чём эта тема
- Как разбить сотни значений на несколько классов картограммы — и почему от выбора метода и числа классов карта может рассказать совсем другую историю.
- Коротко о главном
- Классификация объединяет множество значений в несколько классов (ступеней шкалы): карту легче читать, но это генерализация — часть информации теряется.
- Хорошая классификация собирает в один класс похожие значения и разводит по разным классам непохожие.
- Безопасное число классов — 3–7. Больше классов — точнее, но цвета труднее различить.
- Четыре основных метода: равные интервалы, квантили, естественные границы (Дженкс), ручные границы; ещё один — по стандартному отклонению.
- Прежде чем выбрать метод, посмотрите на гистограмму: асимметрия и выбросы ломают равные интервалы, квантили могут разорвать скопление близких значений.
- Один и тот же набор данных при разной классификации даёт разные карты — это самый простой способ «солгать картой», даже нечаянно.
- Время
- 25 минут + практика
Ключевые термины
- Разбиение диапазона значений показателя на интервалы (классы), каждому из которых на карте соответствует свой условный знак — например, ступень цветовой шкалы картограммы.
- Интервал значений, который на карте изображается одинаково. В отечественной литературе — также градация, ступень шкалы.
- Значения, разделяющие соседние классы. Именно их подписывают в легенде.
- Все классы одинаковой ширины: (максимум − минимум) / число классов.
- Равнонаполненные интервалы: в каждый класс попадает одинаковое число территориальных единиц.
- Метод Дженкса: границы подбираются так, чтобы разброс значений внутри классов был минимальным, а различия между классами — максимальными.
- Мера разброса значений вокруг среднего. В классификации границы ставят на расстоянии ±1σ, ±2σ от среднего.
- Столбчатая диаграмма распределения: сколько значений попадает в каждый узкий интервал. Главный инструмент выбора классификации.
- Значение, резко отличающееся от остальных (например, плотность населения Бангладеш — 1214 чел./км² при медиане ≈ 70).
Конспект
Зачем классифицировать и чем это опасно
Картограмма с классами показывает не 176 разных значений, а 4–6 ступеней цвета. Читателю так проще: несколько чётких классов легче различить и запомнить. Но классификация — это генерализация: мы объединяем разные значения, а небольшие изменения границ могут резко изменить облик карты. Читатель почти никогда не сомневается в границах классов — поэтому неудачная (или нарочно подобранная) классификация незаметно вводит в заблуждение.
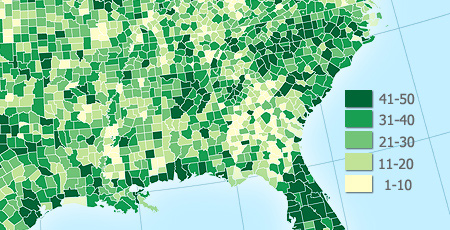
Цель: однородные классы
- Внутри класса — значения похожи (минимальная внутриклассовая дисперсия).
- Между классами — значения заметно различаются.
- Пример: 1,3; 1,6; 3,5; 3,9. Естественно разбить их на {1,3; 1,6} и {3,5; 3,9} по большому разрыву посередине — это метод максимальных разрывов.
- Но иногда важнее критическое значение: если при показателе ниже 1,5 положена помощь, граница должна пройти по 1,5 — и близкие 1,3 и 1,6 окажутся в разных классах.
Сколько классов
| Классов | Плюсы | Минусы |
|---|---|---|
| 2 | Предельно просто: «выше / ниже среднего», «да / нет» | Почти вся информация потеряна |
| 3–7 | Цвета различимы на экране и в печати; карту легко запомнить | Нужно подумать, где провести границы |
| 8 и больше | Меньше генерализация | Соседние оттенки сливаются, растёт число ошибок чтения |
Методы классификации
| Метод | Как строится | Когда хорош | Чем опасен |
|---|---|---|---|
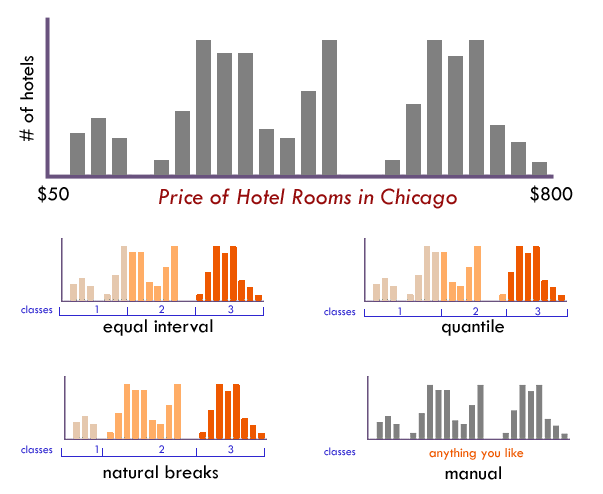
| Равные интервалы | Диапазон делится на k равных частей | Значения более-менее равномерно распределены по всему диапазону; легенда понятна («0–10, 10–20…») | При асимметрии и выбросах почти все объекты попадают в один класс, остальные классы пустуют |
| Квантили | В каждом классе одинаковое число объектов | Важен ранг («20 % самых…»); карта всегда «пёстрая» и привлекательная | Ширина классов очень разная (последний может быть огромным); близкие значения разрываются, далёкие — объединяются |
| Естественные границы (Дженкс) | Оптимизация: минимум разброса внутри классов | В данных есть скопления и разрывы; одиночная карта | Для каждого набора данных — свои границы: карты серии (по годам, по регионам) нельзя сравнивать |
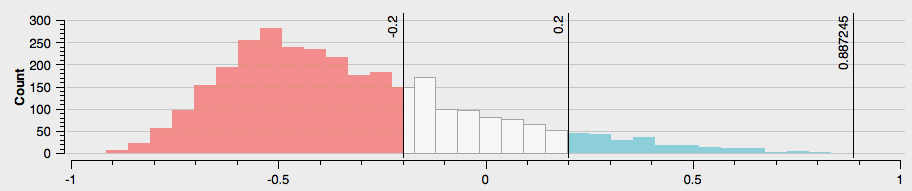
| Стандартное отклонение | Границы на среднем ± 1σ и ± 2σ | Распределение близко к нормальному (симметричному); важно отклонение от среднего — тогда берут расходящуюся шкалу | На асимметричных данных даёт пустые классы и бессмысленные отрицательные границы |
| Ручные границы | Картограф задаёт сам | Есть пороговые (критические) значения, нужны «круглые» числа, одинаковые классы для серии карт | Субъективность — границы надо обосновать |
Наведите курсор на страну. Пунктир на гистограмме — границы классов, цвет столбика — класс.
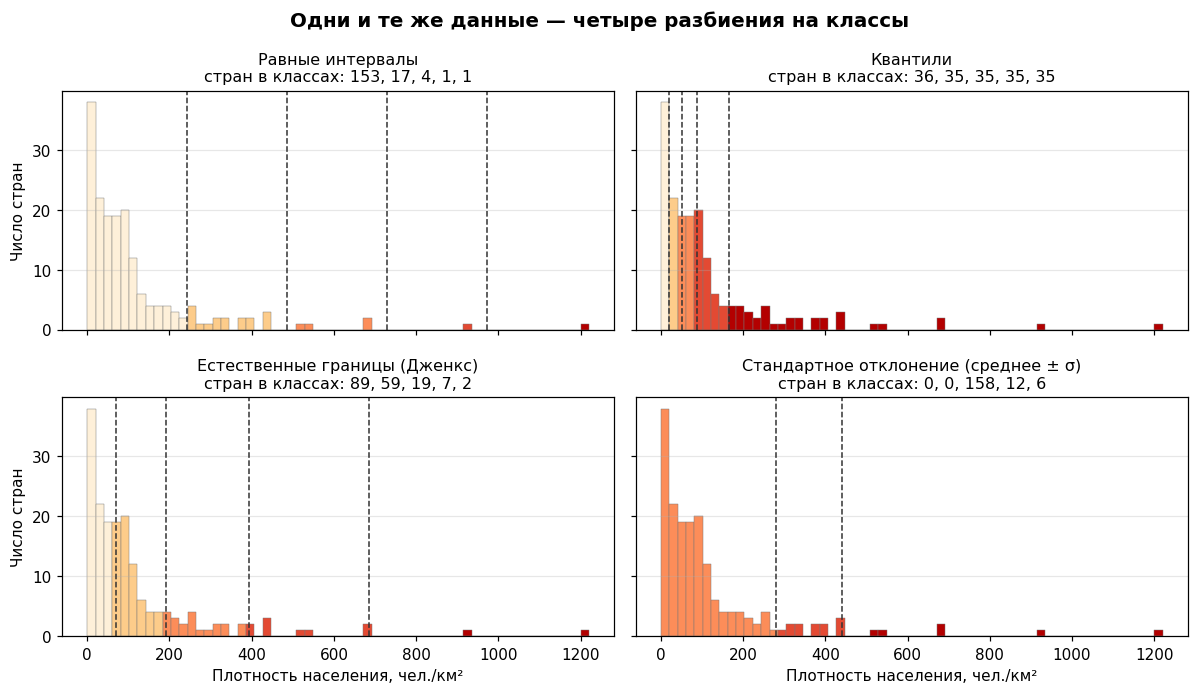
Посмотрите в интерактиве на плотность населения: распределение резко асимметрично (большинство стран — до 150 чел./км², единицы — за 500). Равные интервалы дают почти одноцветную карту, стандартное отклонение — два пустых класса. Включите логарифмическую ось — распределение станет почти симметричным; так часто поступают с плотностью, доходами, численностью.
Choropleth — равные интервалы. Всегда стройте гистограмму и проверяйте, сколько объектов попало в каждый класс.Как построить классификацию на практике
- ГИС: в QGIS и ArcGIS есть все методы и гистограмма в окне настройки стиля.
- JavaScript: библиотека Simple Statistics (функции
ckmeans,quantile,equalIntervalBreaks), шкалы d3 (d3.scaleQuantize,scaleQuantile,scaleThreshold). - Python: библиотека
mapclassify—EqualInterval,Quantiles,FisherJenks,NaturalBreaks,StdMean,UserDefinedи другие. У каждого классификатора есть.bins(верхние границы),.counts(сколько объектов в классе),.yb(номер класса каждого объекта) и метод.get_gadf().
Делаем на Python (folium)
Во всех примерах — плотность населения стран мира (python/data/countries.geojson). Классы считает библиотека mapclassify, карты рисует folium, легенды — помощник add_legend из python/примеры/maptools.py. В скобках в легенде — число стран в классе: это первое, на что стоит смотреть.
Рецепт 1 Четыре метода — одна таблица
Границы классов, число стран в каждом классе и GADF — показатель качества классификации (goodness of absolute deviation fit, 0…1): чем ближе к 1, тем однороднее классы. Естественные границы по построению дают лучший GADF, но сравните, сколько стран попало в последние классы.
"""Четыре метода классификации одних и тех же данных — плотности населения стран.

Для каждого метода печатаем границы классов, число стран в классе
и GADF — меру «качества» классификации (0…1, чем ближе к 1, тем лучше
внутри классов собраны похожие значения).
"""
from pathlib import Path

import geopandas as gpd
import mapclassify

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
world = world[world["iso_a3"] != "ATA"]
y = world["pop_density"]  # чел./км²

print(f"Стран: {len(y)}; минимум {y.min():.2f}, медиана {y.median():.1f}, "
      f"среднее {y.mean():.1f}, максимум {y.max():.0f} чел./км²\n")

k = 5
methods = {
    "Равные интервалы": mapclassify.EqualInterval(y, k=k),
    "Квантили": mapclassify.Quantiles(y, k=k),
    "Естественные границы (Дженкс)": mapclassify.FisherJenks(y, k=k),
    "Стандартное отклонение": mapclassify.StdMean(y),  # границы: среднее ± 1 и 2 σ
}

for name, c in methods.items():
    # нижняя граница класса = верхняя граница предыдущего; у первого — минимум данных
    first = f"{y.min():.1f}" if c.bins[0] >= y.min() else "−∞"
    lows = [first] + [f"{b:.1f}" for b in c.bins[:-1]]
    print(f"{name}   GADF = {c.get_gadf():.2f}")
    for lo, hi, n in zip(lows, c.bins, c.counts):
        bar = "█" * (n // 4)
        print(f"   {lo:>8} – {hi:7.1f}   {n:3d} стран  {bar}")
    print()

print("У стандартного отклонения два пустых класса: среднее − σ < 0,")
print("а отрицательной плотности не бывает. Метод рассчитан на симметричные данные.\n")

# Самые «плотные» страны — те самые выбросы, которые растягивают равные интервалы
top = world.nlargest(5, "pop_density")[["name_ru", "pop_density"]]
print("Пять самых густонаселённых стран:")
print(top.to_string(index=False, header=False))
Стран: 176; минимум 0.01, медиана 69.8, среднее 117.4, максимум 1214 чел./км²

Равные интервалы   GADF = 0.48
        0.0 –   242.8   153 стран  ██████████████████████████████████████
      242.8 –   485.6    17 стран  ████
      485.6 –   728.4     4 стран  █
      728.4 –   971.2     1 стран
      971.2 –  1214.0     1 стран

Квантили   GADF = 0.58
        0.0 –    19.3    36 стран  █████████
       19.3 –    50.2    35 стран  ████████
       50.2 –    88.4    35 стран  ████████
       88.4 –   166.3    35 стран  ████████
      166.3 –  1214.0    35 стран  ████████

Естественные границы (Дженкс)   GADF = 0.68
        0.0 –    70.7    89 стран  ██████████████████████
       70.7 –   192.4    59 стран  ██████████████
      192.4 –   392.6    19 стран  ████
      392.6 –   684.2     7 стран  █
      684.2 –  1214.0     2 стран

Стандартное отклонение   GADF = 0.40
         −∞ –  -205.4     0 стран
     -205.4 –   -44.0     0 стран
      -44.0 –   278.8   158 стран  ███████████████████████████████████████
      278.8 –   440.2    12 стран  ███
      440.2 –  1214.0     6 стран  █

У стандартного отклонения два пустых класса: среднее − σ < 0,
а отрицательной плотности не бывает. Метод рассчитан на симметричные данные.

Пять самых густонаселённых стран:
Бангладеш 1214.04
Палестина  927.42
  Тайвань  684.21
    Ливан  677.11
   Руанда  536.84
Рецепт 2 Гистограмма с границами классов
matplotlib рисует гистограмму, а мы красим каждый столбик в цвет его класса и проводим границы пунктиром. Сразу видно: у равных интервалов почти всё в первом классе, у стандартного отклонения два класса пусты (их границы отрицательны).
"""Гистограмма плотности населения и границы классов четырёх методов.

Прежде чем выбирать метод классификации, посмотрите на распределение.
Здесь оно резко асимметрично: большинство стран — меньше 150 чел./км²,
а несколько выбросов доходят до 1200.
"""
from pathlib import Path

import geopandas as gpd
import mapclassify
import matplotlib.pyplot as plt

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
y = world.loc[world["iso_a3"] != "ATA", "pop_density"]

methods = [
    ("Равные интервалы", mapclassify.EqualInterval(y, k=5)),
    ("Квантили", mapclassify.Quantiles(y, k=5)),
    ("Естественные границы (Дженкс)", mapclassify.FisherJenks(y, k=5)),
    ("Стандартное отклонение (среднее ± σ)", mapclassify.StdMean(y)),
]
colors = ["#fef0d9", "#fdcc8a", "#fc8d59", "#e34a33", "#b30000"]  # YlOrRd/OrRd, 5 классов

fig, axes = plt.subplots(2, 2, figsize=(11, 6.4), sharex=True, sharey=True)
for ax, (title, c) in zip(axes.flat, methods):
    # раскрашиваем столбики гистограммы в цвет класса, в который попадает их середина
    n, edges, patches = ax.hist(y, bins=60, range=(0, 1220), edgecolor="#777", linewidth=0.3)
    for left, right, p in zip(edges[:-1], edges[1:], patches):
        cls = min(int((c.bins < (left + right) / 2).sum()), len(colors) - 1)
        p.set_facecolor(colors[cls])
    for b in c.bins[:-1]:
        if b > 0:  # у StdMean нижние границы отрицательны — их не рисуем
            ax.axvline(b, color="#333", linestyle="--", linewidth=1)
    ax.set_title(f"{title}\nстран в классах: {', '.join(map(str, c.counts))}", fontsize=10.5)
    ax.grid(axis="y", alpha=0.3)
for ax in axes[1]:
    ax.set_xlabel("Плотность населения, чел./км²")
for ax in axes[:, 0]:
    ax.set_ylabel("Число стран")
fig.suptitle("Одни и те же данные — четыре разбиения на классы", fontsize=13, fontweight="bold")
fig.tight_layout()
plt.savefig("02_histograms.png", dpi=110, bbox_inches="tight")
Рецепт 3 Равные интервалы против квантилей
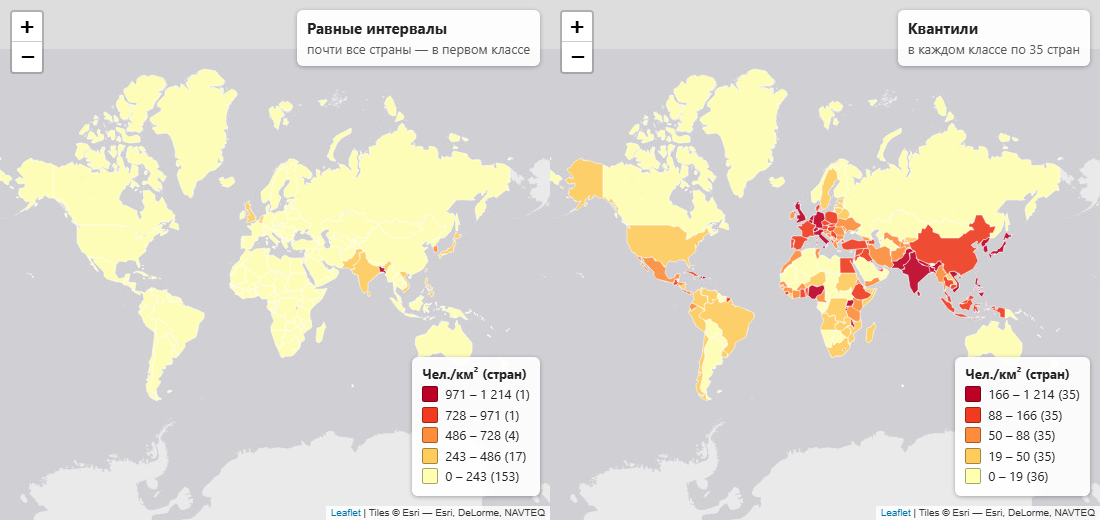
Слева мир почти одноцветный: выделяются только Индия, Бангладеш и несколько стран Европы и Восточной Азии. Справа карта «пёстрая», но пятый класс охватывает значения от 166 до 1214 — Германия (233 чел./км²) и Бангладеш (1214) в нём неразличимы.
# screenshot: 1100x520
"""Равные интервалы против квантилей на одних и тех же данных.

Плотность населения распределена резко асимметрично. Равные интервалы
«съедают» почти все страны первым классом, квантили раскрашивают карту
равномерно, но последний класс у них огромный: от 166 до 1214 чел./км².
"""
import sys
from pathlib import Path

import folium
import geopandas as gpd
import mapclassify
from branca.utilities import color_brewer
from folium.plugins import DualMap

sys.path.insert(0, str(Path(__file__).resolve().parents[1]))
from maptools import add_legend, add_title, fmt, plain_attribution

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
world = world[world["iso_a3"] != "ATA"]
COLORS = color_brewer("YlOrRd", 5)


def add_classed(target, classifier, title):
    """Картограмма по готовому классификатору mapclassify + легенда с числом стран."""
    gdf = world.assign(color=[COLORS[c] for c in classifier.yb])  # yb — номер класса
    folium.GeoJson(
        gdf[["name_ru", "pop_density", "color", "geometry"]],
        style_function=lambda f: {"fillColor": f["properties"]["color"], "color": "white",
                                  "weight": 0.5, "fillOpacity": 0.9},
        tooltip=folium.GeoJsonTooltip(["name_ru", "pop_density"], aliases=["Страна", "Чел./км²"]),
    ).add_to(target)
    lows = [world["pop_density"].min()] + list(classifier.bins[:-1])
    labels = [f"{fmt(lo)} – {fmt(hi)} ({n})" for lo, hi, n in zip(lows, classifier.bins, classifier.counts)]
    add_legend(target, title, COLORS[::-1], labels[::-1])


m = DualMap(location=[30, 15], zoom_start=1, tiles="Esri.WorldGrayCanvas")
y = world["pop_density"]
add_classed(m.m1, mapclassify.EqualInterval(y, k=5), "Чел./км² (стран)")
add_title(m.m1, "Равные интервалы", "почти все страны — в первом классе")
add_classed(m.m2, mapclassify.Quantiles(y, k=5), "Чел./км² (стран)")
add_title(m.m2, "Квантили", "в каждом классе по 35 стран")
plain_attribution(m)
m.save("03_equal_vs_quantiles.html")
Рецепт 4 Естественные границы и ручные границы
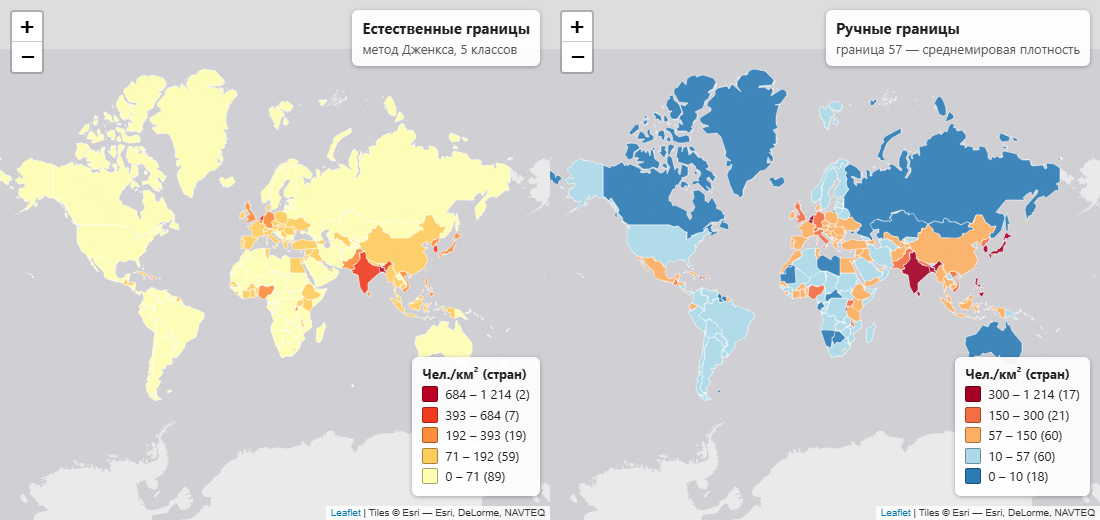
Ручная классификация с критическим значением: одна из границ — среднемировая плотность населения (≈ 57 чел./км²). Раз есть осмысленная «середина», берём расходящуюся шкалу: синие страны заселены реже, чем мир в среднем, красные — гуще. Обратите внимание: среднемировая плотность (всё население / вся площадь) и среднее по странам — разные числа.
# screenshot: 1100x520
"""Естественные границы (метод Дженкса) против ручной классификации.

Справа границы заданы вручную: «круглые» числа и одно КРИТИЧЕСКОЕ значение —
среднемировая плотность населения. Теперь по цвету сразу видно,
какие страны заселены гуще, а какие реже, чем мир в среднем.
"""
import sys
from pathlib import Path

import folium
import geopandas as gpd
import mapclassify
from branca.utilities import color_brewer
from folium.plugins import DualMap

sys.path.insert(0, str(Path(__file__).resolve().parents[1]))
from maptools import add_legend, add_title, fmt, plain_attribution

DATA = Path(__file__).resolve().parents[2] / "data"
world = gpd.read_file(DATA / "countries.geojson")
world = world[world["iso_a3"] != "ATA"]
y = world["pop_density"]


def add_classed(target, classifier, colors, title):
    gdf = world.assign(color=[colors[c] for c in classifier.yb])
    folium.GeoJson(
        gdf[["name_ru", "pop_density", "color", "geometry"]],
        style_function=lambda f: {"fillColor": f["properties"]["color"], "color": "white",
                                  "weight": 0.5, "fillOpacity": 0.9},
        tooltip=folium.GeoJsonTooltip(["name_ru", "pop_density"], aliases=["Страна", "Чел./км²"]),
    ).add_to(target)
    lows = [y.min()] + list(classifier.bins[:-1])
    labels = [f"{fmt(lo)} – {fmt(hi)} ({n})" for lo, hi, n in zip(lows, classifier.bins, classifier.counts)]
    add_legend(target, title, colors[::-1], labels[::-1])


# Среднемировая плотность: всё население / вся площадь (а не среднее по странам!)
world_avg = world["pop_est"].sum() / world["area_km2"].sum()
print(f"Среднемировая плотность: {world_avg:.1f} чел./км²")
print(f"Среднее арифметическое по странам: {y.mean():.1f} чел./км² — это другое число")

m = DualMap(location=[30, 15], zoom_start=1, tiles="Esri.WorldGrayCanvas")

jenks = mapclassify.FisherJenks(y, k=5)
add_classed(m.m1, jenks, color_brewer("YlOrRd", 5), "Чел./км² (стран)")
add_title(m.m1, "Естественные границы", "метод Дженкса, 5 классов")

# Ручные границы: 10, среднемировая, 150, 300 и максимум
manual = mapclassify.UserDefined(y, bins=[10, round(world_avg), 150, 300, y.max()])
# Расходящаяся шкала: синие — реже среднего, красные — гуще
diverging = ["#2c7bb6", "#abd9e9", "#fdae61", "#f46d43", "#a50026"]
add_classed(m.m2, manual, diverging, "Чел./км² (стран)")
add_title(m.m2, "Ручные границы", f"граница {round(world_avg)} — среднемировая плотность")
plain_attribution(m)
m.save("04_jenks_vs_manual.html")
Среднемировая плотность: 56.6 чел./км²
Среднее арифметическое по странам: 117.4 чел./км² — это другое число
Проверь себя
В данных есть один огромный выброс. Чем это плохо для равных интервалов?
- Метод не сможет построить границы
- Почти все объекты окажутся в одном-двух классах, остальные будут пустыми
- Классы получатся с одинаковым числом объектов
- Ничем — выбросы на равные интервалы не влияют
30 районов разбили на 6 классов методом квантилей. Сколько районов в каждом классе?
- 6
- Зависит от распределения
- 30
- 5
Вы готовите серию карт безработицы по годам (2015, 2020, 2025). Какую классификацию выбрать?
- Одинаковые (ручные) границы для всех карт
- Естественные границы для каждой карты отдельно
- Квантили для каждой карты отдельно
- Каждый год — новое число классов
Что минимизирует метод естественных границ Дженкса?
- Число классов
- Разницу в числе объектов между классами
- Разброс значений внутри классов
- Ширину самого большого класса
Для какого распределения хорошо подходит классификация по стандартному отклонению?
- Резко асимметричного, с длинным «хвостом»
- Близкого к нормальному, симметричного относительно среднего
- Распределения номинальных данных
- Любого — метод универсален
Практическое задание
Постройте картограмму ВВП на душу населения (gdp_per_capita, страны без данных исключите). Сначала постройте гистограмму, затем сравните на DualMap два метода классификации на ваш выбор. Напишите 2–3 предложения: какой метод лучше передаёт различия между странами и почему.
- Построена гистограмма, по ней выбрано число классов (3–7)
- В легенде — границы классов, единицы измерения и число стран в классе
- Шкала последовательная (или расходящаяся — только если есть осмысленная середина)
- Проверено, нет ли пустых или переполненных классов
- Вывод обоснован ссылкой на гистограмму
Источники
- The Basics of Data Classification / Axis Maps. — Текст : электронный // Cartography Guide : [сайт]. — URL: https://www.axismaps.com/guide/data-classification (дата обращения: 27.10.2026).
- Natural Earth : free vector and raster map data : [сайт]. — URL: https://www.naturalearthdata.com/ (дата обращения: 27.10.2026). — Текст : электронный.
- Folium : documentation : [сайт]. — URL: https://python-visualization.github.io/folium/latest/ (дата обращения: 27.10.2026). — Текст : электронный.
Конспект подготовлен по переводу руководства Cartography Guide © Axis Maps (лицензия CC BY-NC-SA 4.0) и распространяется на тех же условиях: с указанием авторства, в некоммерческих целях, с сохранением условий лицензии.